IA multimodale : fonctionnement, usages et limites
Une application d’IA multimodale accepte plusieurs types de contenus — texte, images, documents — et les traite dans une même conversation. Vous avez sans doute ce genre de mélange sous les yeux : une photo de tableau blanc prise au téléphone, un PDF que vous n’avez pas encore ouvert et un tableur dont le total vous laisse perplexe. La vraie question n’est pas de savoir si une application peut lire les trois. C’est de savoir si vous pouvez remonter de sa réponse à la bonne diapositive, à la bonne page ou à la bonne cellule avant de prendre une décision.
Sommaire
- L’IA multimodale, tout simplement
- Les contenus qu’elle accepte et les résultats qu’elle produit
- Comment un même modèle combine texte, images et fichiers
- Les tâches documentaires et de recherche qui en profitent le plus
- Les erreurs des applications multimodales et les moyens de les repérer
- Les questions de confidentialité à poser avant d’importer vos fichiers
- Choisir l’application d’IA multimodale adaptée à votre travail
L’IA multimodale, tout simplement
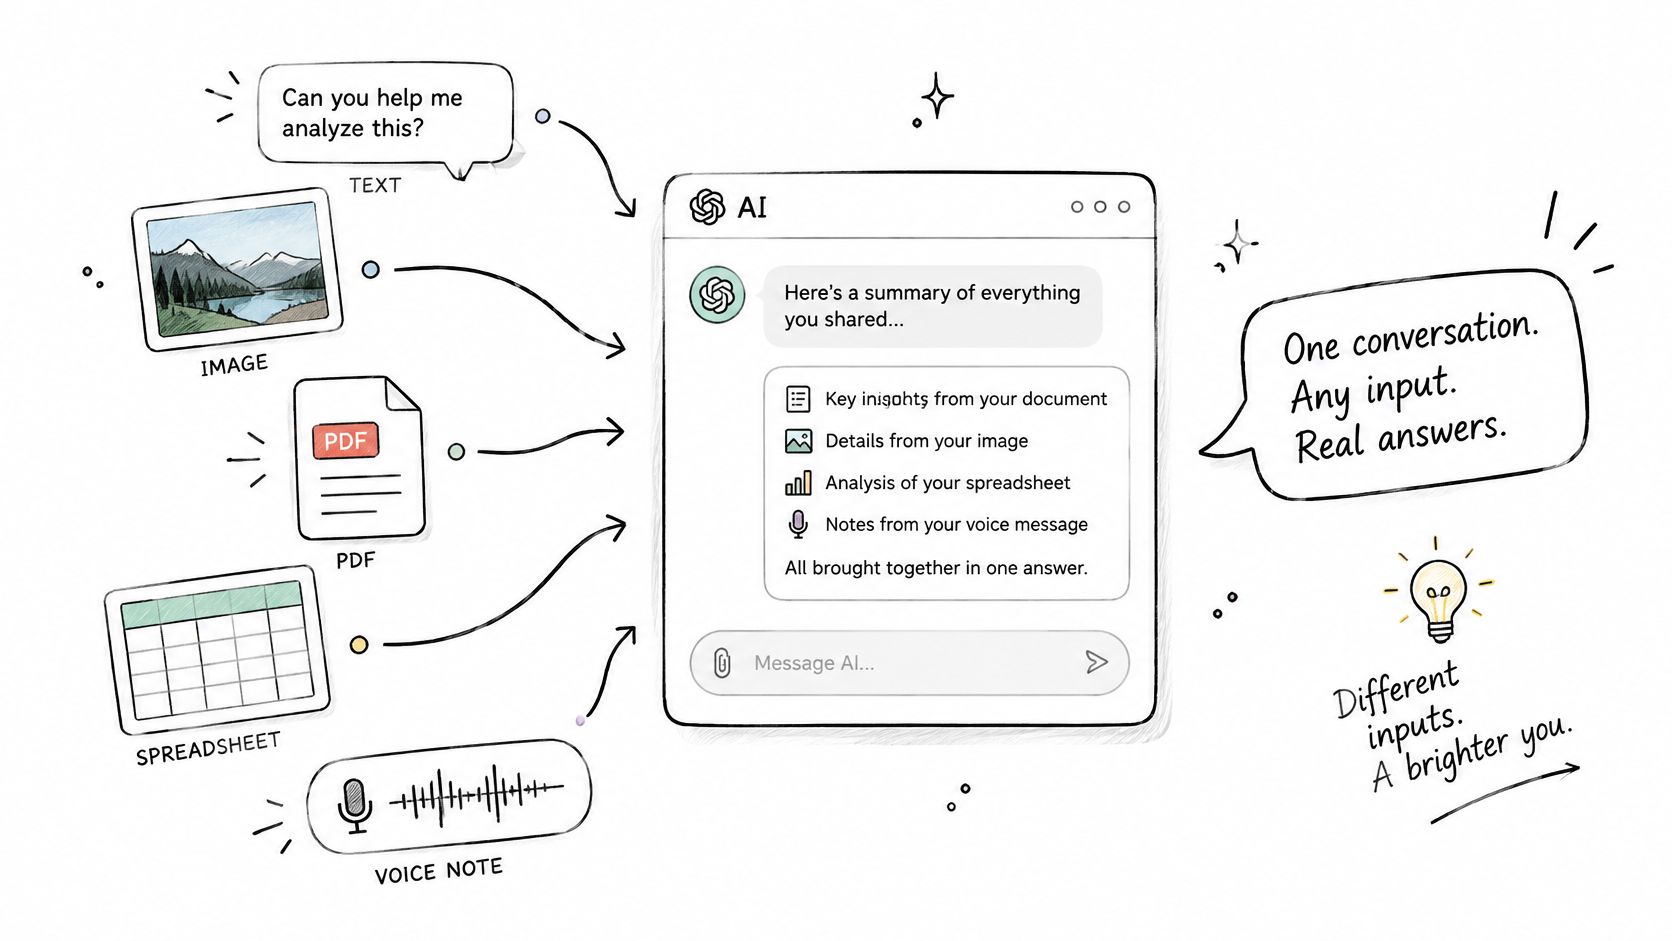
Une application d’IA multimodale accepte plusieurs types de contenus : texte saisi au clavier, photos, PDF, tableurs ou notes vocales. Elle les traite dans une même conversation, au lieu de vous obliger à utiliser un outil différent pour chaque format. Le principe tient en une phrase. Une modalité désigne simplement un type d’information ; « multimodal » signifie donc que plusieurs types sont pris en charge ensemble.
Imaginez un chatbot limité au texte comme un lecteur qui ne sait traiter que des courriers imprimés. Donnez-lui un graphique : il sera bloqué, car ce n’est pas une lettre. Une application multimodale ressemble plutôt à un collègue assis à côté de vous, capable de lire le courrier, d’étudier le graphique joint, d’écouter votre note vocale à leur sujet, puis de rédiger une synthèse qui s’appuie sur les trois.
Un après-midi d’études pour exemple
Prenons un étudiant qui photographie trois diapositives de cours, importe un PDF de notes de lecture et pose une question dans le même fil. L’application ne traite pas ces éléments comme trois tâches sans rapport. Elle lit le schéma de la deuxième diapositive, retrouve l’explication correspondante à la quatrième page des notes et formule une réponse qui renvoie aux deux sources. L’étudiant peut alors rouvrir la diapositive et la page en question pour vérifier que la réponse correspond bien au contenu.
Cette dernière étape compte davantage que la prouesse technique. Il faut bien distinguer deux sens de circulation. Les entrées sont ce que vous fournissez à l’application : une question, une photo ou un fichier. Les sorties sont ce qu’elle vous renvoie : du texte, un tableau, une liste extraite d’un document ou une image générée. Confondre les deux conduit à croire qu’une application a compris l’intégralité d’un fichier simplement parce qu’elle l’a accepté. Accepter et comprendre sont deux choses différentes.
Le marché se développe rapidement, ce qui explique en partie pourquoi tant d’outils se présentent aujourd’hui comme multimodaux. Le rapport de Research and Markets sur l’IA multimodale évalue le marché mondial à 1,6 milliard de dollars en 2024 et prévoit qu’il atteindra 27 milliards de dollars d’ici 2034. Une telle projection indique que les fournisseurs continueront d’ajouter la prise en charge des fichiers et des images. Elle ne dit rien, en revanche, de la capacité d’une application donnée à lire correctement vos documents.
Une application multimodale ne mérite sa place dans vos outils que si vous pouvez vérifier sa réponse dans le fichier d’origine en moins d’une minute.
La suite décompose cette idée en points que vous pouvez tester vous-même : les types de contenus acceptés et leurs risques, la façon dont un modèle les combine, les erreurs possibles, les questions de confidentialité à poser avant d’importer des données sensibles et les critères de choix adaptés à vos usages.
Les contenus qu’elle accepte et les résultats qu’elle produit
Parcourez d’abord ce tableau, puis les précisions qui suivent. Chaque ligne présente un type de contenu que l’application peut lire ; la dernière colonne indique ce qu’elle renvoie habituellement.
| Type de contenu fourni | Exemple courant | Résultat renvoyé |
|---|---|---|
| Texte | Notes, questions, brouillons | Synthèses, reformulations, réponses |
| Images et photos | Captures d’écran, schémas, notes manuscrites | Descriptions, texte extrait, retouches |
| PDF et fichiers Word | Contrats, rapports, articles scientifiques | Réponses avec références aux pages |
| Tableurs | Tableaux XLSX et CSV | Totaux, tendances, lignes signalées |
| Audio et voix | Enregistrements, dictées | Transcriptions et synthèses |
| Vidéo | Cours, extraits vidéo | Résumés des scènes avec repères temporels |
| Sources web | Résultats de recherche en temps réel | Réponses avec liens vers les sources |
Une question en texte brut est le cas le plus simple du tableau. Aucune mise en page à mal interpréter, aucune image à déchiffrer : le principal risque est d’obtenir une réponse vague à une question vague. Chaque ligne suivante ajoute une étape au cours de laquelle une partie du sens peut se perdre entre votre fichier et ce que le modèle en comprend.
Les deux formats qui posent le plus de problèmes
Un PDF est plus complexe qu’il n’y paraît, car sa mise en page est porteuse de sens. Un rapport peut placer une réserve en note de bas de page, répartir un tableau sur deux pages ou juxtaposer un graphique et le paragraphe qui l’explique. Si l’application n’extrait que le corps du texte, la note peut disparaître et le graphique se réduire à une légende, sans les données qui l’étayent. Les références aux pages constituent ici votre garde-fou : elles permettent d’ouvrir la bonne page et de comparer.
Un tableur présente un autre piège. L’outil est utile lorsqu’il lit les cellules et les formules d’un fichier XLSX ou les valeurs d’un CSV : le total peut alors être recalculé à partir des données réelles. Il est bien moins fiable si vous importez une capture d’écran du tableau. L’application lit alors une image de nombres, avec le risque d’inverser des chiffres ou de manquer une ligne masquée. La même logique s’applique aux pages numérisées. Un scan reste une image tant que l’application n’a pas effectué de reconnaissance de texte, et cette étape peut déjà mélanger les colonnes avant même que le raisonnement commence.
L’audio et la vidéo suivent un schéma similaire. Un enregistrement est généralement transcrit, et une vidéo convertie en images accompagnées de notes horodatées, avant que le modèle ne les analyse. C’est lors de cette conversion que les noms peuvent être mal compris et que les remarques prononcées à voix basse disparaissent.
Règle pratique : importez le format d’origine le plus riche dont vous disposez. Convertir vous-même un contrat numérisé en texte brut peut faire disparaître la structure du tableau dont dépend votre question.
Côté résultats, les visuels générés méritent autant d’attention que le texte. Si vous cherchez un outil pour créer des images dans votre travail, mieux vaut comparer les générateurs d’images par IA selon les styles et les réglages dont vous avez besoin, plutôt que de supposer que tous se valent. Le point commun à toutes les lignes du tableau reste le partage du contexte. Une application d’IA multimodale ne peut comparer la photo d’une facture à un tableau de paiements que si les deux fichiers figurent dans la même conversation. Gardez donc les documents liés dans un seul fil, au lieu de les disperser entre plusieurs discussions.
Comment un même modèle combine texte, images et fichiers
La plupart des applications que vous essaierez reposent sur l’une de ces deux architectures, dont les faiblesses se situent à des endroits différents. Savoir laquelle vous utilisez permet de mieux cibler vos vérifications.
L’approche classique : une course de relais
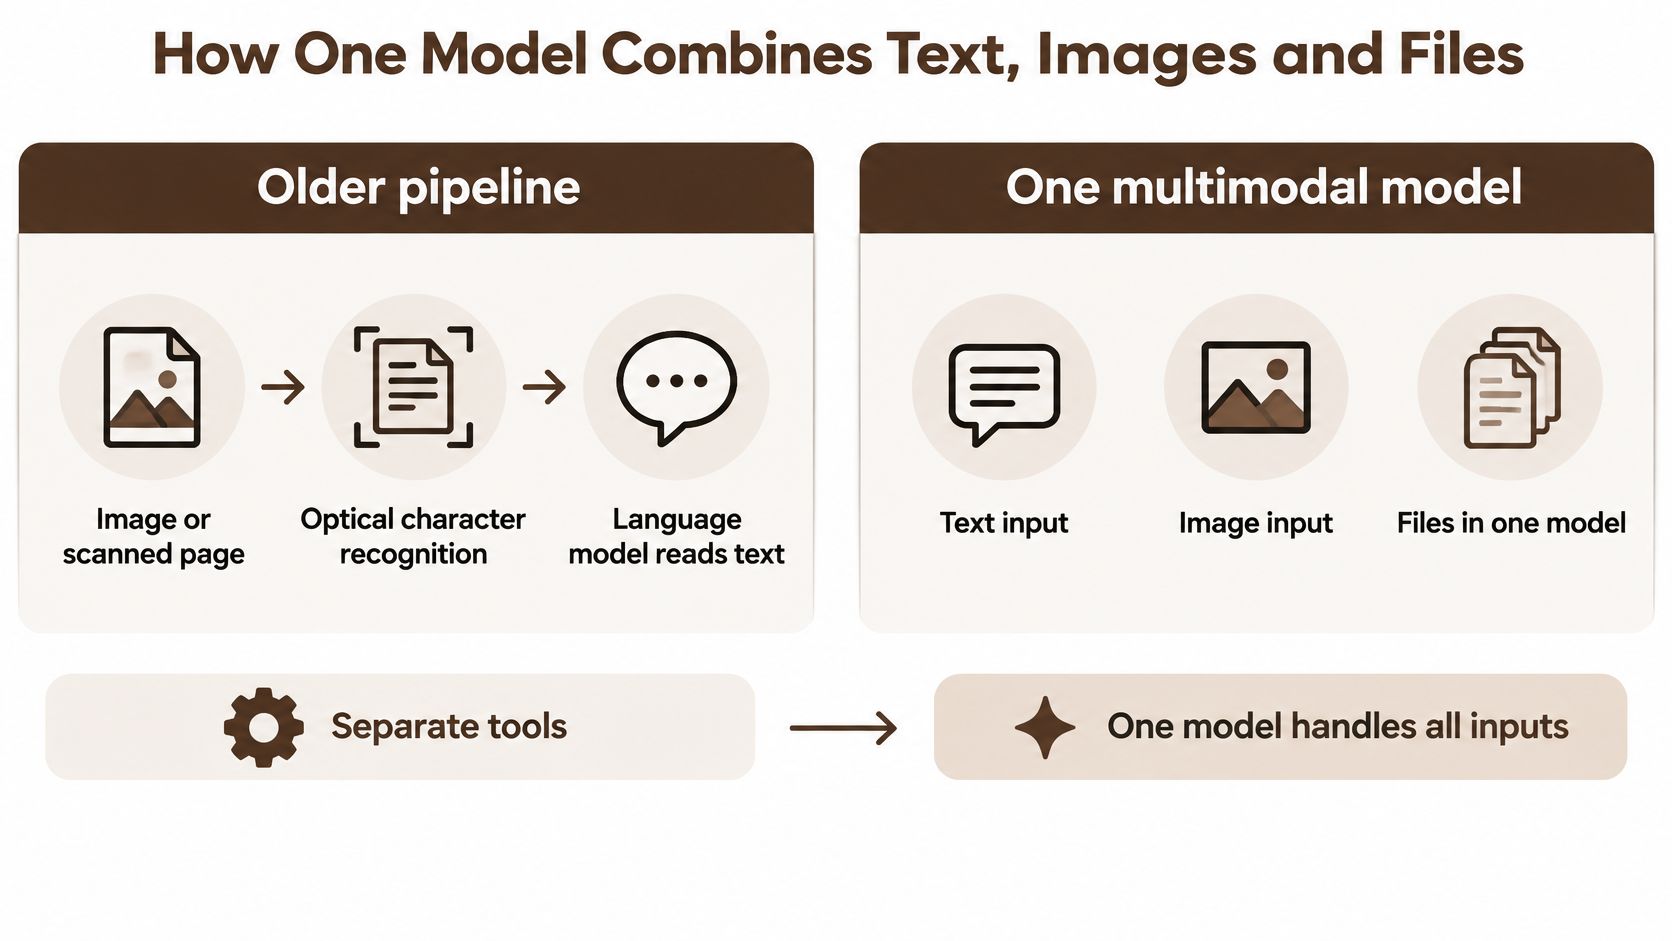
Dans l’approche classique, des outils distincts traitent chaque format successivement. La reconnaissance optique de caractères, généralement appelée OCR, transforme une image ou une page numérisée en texte. Un modèle de langage lit ensuite le texte extrait et répond. Imaginez une course de relais : chaque spécialiste effectue une étape, puis transmet ses notes au suivant.
Cette course a une faiblesse bien connue : ce que le premier coureur laisse tomber n’arrive jamais au second. Si l’OCR fusionne deux colonnes d’un tableau en une seule ligne, le modèle de langage qui intervient ensuite n’a aucun moyen de savoir qu’elles étaient séparées. Il raisonne avec aisance sur des données dégradées et produit une réponse assurée, fondée sur une erreur de mise en page qu’il ne peut pas voir.
Un seul modèle lit toute la page d’un coup
Dans une architecture nativement multimodale, un même modèle est entraîné à traiter plusieurs médias dans un contexte commun. La photo, sa légende et votre question sont lues ensemble, comme par une personne qui voit toute la page plutôt que de s’en remettre au récit d’un intermédiaire. Les indices spatiaux sont mieux préservés, car le modèle peut exploiter la position des éléments sur la page, et pas seulement les mots qui en ont été extraits.
Gemini, de Google, est un jalon de cette évolution. Selon le bilan 2023 de Google Research, Gemini a été lancé en décembre 2023 comme un modèle conçu dès le départ pour traiter texte, audio, images et vidéo, plutôt que de confier chaque média à un système distinct. Google a annoncé que Gemini Ultra avait dépassé les meilleures performances connues sur 30 des 32 tests de référence académiques couramment utilisés, obtenu 90,04 % au test Massive Multitask Language Understanding et 59,4 % au test plus récent Massive Multimodal Multitask Understanding.
Prenez ces chiffres pour ce qu’ils sont : des résultats à des tests de recherche, avec des questions connues et des documents de bonne qualité, pas des mesures de performance sur vos contrats numérisés ou l’écriture de votre enseignant. Ce lancement a marqué une étape, car il a montré qu’un modèle généraliste pouvait combiner consignes écrites, supports visuels, audio, vidéo, code et contenu mathématique dans un même processus de raisonnement. De nombreuses applications actuelles suivent cette approche pour cette raison. Cela ne garantit pas que votre fichier, lui, sera correctement lu.
Aucune des deux architectures ne vous dispense de vérifier. L’approche en relais perd des informations lors des transmissions. Le modèle unique conserve davantage de contexte, mais peut tout de même mal interpréter un graphique ou ignorer une note de bas de page enfouie à la page trente. Posez donc une question directe à propos de toute application que vous évaluez.
Cette application conserve-t-elle la page d’origine et sa mise en page, ou seulement le texte extrait ?
La réponse détermine quelle part de votre source se retrouve dans le résultat. Si seul le texte extrait est conservé, considérez toute affirmation sur les tableaux, les graphiques et la structure des pages comme non vérifiée tant que vous ne l’avez pas comparée à l’affichage du document d’origine.
Les tâches documentaires et de recherche qui en profitent le plus
Commencez par un cas où le gain est concret. Un fournisseur vous envoie un contrat en PDF et trois factures numérisées ; de votre côté, vous suivez les paiements dans un tableur. Pour vérifier qu’une même facture n’a pas été réglée deux fois, il faut croiser l’ensemble de ces documents. C’est précisément le genre de tâche auquel un espace de travail multimodal se prête bien.
Avec BromeAI, une seule question peut porter sur tous les fichiers importés : le contrat, ses factures et le tableau de paiements peuvent ainsi être vérifiés dans un même fil. Notre page consacrée à l’analyse de documents montre comment cela fonctionne en pratique. Quatre tâches illustrent bien le principe, chacune avec un résultat différent à vérifier.
- Analyse de contrat : l’application signale les clauses à risque et indique la page de chacune. Vous pouvez ainsi ouvrir la bonne page et lire la clause dans son contexte avant de vous en inquiéter.
- Détection des factures en double : les numéros et montants des factures numérisées sont comparés au tableau de paiements. Tout numéro présent deux fois est listé pour vérification.
- Synthèse de tableur : les totaux, les tendances et les lignes signalées proviennent des cellules et des formules elles-mêmes. Vous pouvez donc recalculer un total à la main pour contrôler le résultat.
- Note de recherche : les sources web sont rassemblées et chaque affirmation est accompagnée d’un lien, ce qui fait immédiatement ressortir les éléments non étayés.
Pourquoi un seul fil vaut mieux que quatre outils
Étudiants, analystes et petites équipes manipulent souvent un PDF, une capture d’écran et un tableau dans la même semaine. Transférer des chiffres d’un outil à l’autre par copier-coller crée ses propres erreurs, et l’on finit par ne plus savoir de quel fichier vient tel nombre. Un espace de travail unique garde les sources et les réponses côte à côte. Le même fil peut aussi accueillir de nouveaux fichiers au fur et à mesure : il devient un suivi continu du projet, plutôt qu’un empilement de conversations sans lien.
Certaines tâches vont au-delà d’une simple question. L’IA agentique réalise de façon autonome un travail en plusieurs étapes — recherche sur le web, lecture de sources, génération d’images — puis vous présente le résultat une fois toutes les tâches terminées. Si vous comparez des outils spécialement conçus pour ces travaux de recherche approfondie, vous pouvez consulter un comparatif d’assistants de recherche IA et confronter leurs points forts aux tâches ci-dessus.
Les chiffres d’adoption expliquent pourquoi les fournisseurs continuent de développer ces espaces de travail intégrés. Dans l’enquête mondiale de McKinsey menée du 22 février au 5 mars 2024, 65 % des répondants déclaraient que leur organisation utilisait l’IA générative dans au moins une fonction de l’entreprise, et 40 % dans plus de deux fonctions. Un usage aussi transversal se limite rarement à un seul format de fichier : les tâches documentaires et de recherche sont donc les premières à en profiter.
Les erreurs des applications multimodales et les moyens de les repérer
L’erreur la plus courante est aussi la plus facile à manquer. L’application lit un graphique, décrit une tendance dans un langage fluide et assuré, mais se trompe de sens parce qu’elle a confondu les axes. Un chatbot limité au texte ne peut pas commettre cette erreur puisqu’il n’a jamais vu le graphique. Les applications multimodales peuvent se tromper de davantage de façons précisément parce qu’elles acceptent davantage de types de contenus.
Les tests de référence donnent une idée de l’ampleur du risque. Un test présenté dans des travaux récents sur les modèles multimodaux rapporte un taux de bonnes réponses de 93 % chez les humains, contre 63,0 % pour les meilleurs modèles, sur des questions portant sur des graphiques. Les questions faisant fortement appel au raisonnement visuel entraînent des baisses de performance de 35 % à 55 %. Ces mêmes travaux soulignent qu’extraire le texte avant de raisonner peut faire perdre les relations spatiales et les codes graphiques : c’est le problème du relais, cette fois mesuré. Un document long amplifie la difficulté. Le test MMLONGBENCH-DOC comprend 1 082 questions annotées par des experts, portant sur 135 longs documents PDF de 47,5 pages en moyenne. Le meilleur système évalué n’a obtenu qu’un score F1 de 44,9 %. La longueur, combinée au mélange de textes, d’images et de tableaux, multiplie les occasions de manquer une note ou de mal lire une colonne.
| Type d’erreur | Signal d’alerte | Vérification avant d’agir |
|---|---|---|
| Graphique mal interprété | Une tendance annoncée contredit les libellés des axes | Demandez les valeurs exactes, puis comparez-les au graphique |
| Structure de tableau perdue | Des colonnes sont décalées ou des cellules fusionnées dans la réponse | Comparez le tableau extrait à la page d’origine |
| Notes de bas de page oubliées | La réponse ignore une annexe ou une mention en petits caractères | Demandez le numéro de page qui étaye chaque affirmation |
| Totaux erronés | Les sommes diffèrent de celles du tableur | Recalculez le total dans le fichier source |
| Risques signalés sans justification | Une clause est signalée sans être citée | Ouvrez la clause indiquée et lisez-la avant d’agir |
Repérer chaque erreur en pratique
Un graphique mal interprété se repère d’abord à un décalage entre les mots et les axes. Si l’application affirme que les ventes augmentent alors que les libellés indiquent que la courbe représente les retours, arrêtez-vous et demandez les valeurs exactes représentées. Des nombres sont plus faciles à comparer au graphique qu’une tendance formulée en toutes lettres. Un modèle qui a inventé la tendance peine généralement à fournir des valeurs cohérentes avec la grille.
La perte de structure d’un tableau est plus discrète. La réponse semble bien présentée, mais la colonne des remises a glissé dans celle des totaux. Ouvrez la page d’origine à côté du tableau extrait et vérifiez une ligne entière, de gauche à droite. Si tout correspond sur cette ligne, la structure a probablement été préservée. Sinon, aucun calcul fondé sur ce tableau n’est fiable.
Les notes de bas de page oubliées et les risques signalés sans justification appellent la même réponse : exigez une référence précise pour chaque affirmation. Un risque contractuel doit être accompagné d’un numéro de page et d’une citation du passage concerné. Notre guide sur les bons réflexes pour vérifier les réponses de l’IA explique comment obtenir ces preuves. Un signalement sans citation est un avis, pas un constat.
Les totaux erronés se vérifient de la façon la plus simple : refaites la somme dans le tableur source. Si l’application a correctement lu les cellules, les deux montants correspondront au centime près.
Avant de faire confiance à une nouvelle application : testez-la sur un fichier dont vous connaissez déjà la réponse, par exemple une facture au total connu, et vérifiez si elle retrouve votre chiffre.
Ce seul test vous en apprend plus que n’importe quelle liste de fonctionnalités. Pour les résultats à fort enjeu, fixez une règle claire : un total financier ou un risque contractuel doit toujours s’accompagner d’une référence visible à la source, puis d’un recalcul ou d’une relecture rapide de votre côté. Une réponse bien présentée n’est pas une preuve d’exactitude. Deux minutes de vérification coûtent bien moins cher qu’un chiffre faux dans un rapport sur lequel d’autres s’appuient.
Les questions de confidentialité à poser avant d’importer vos fichiers
Après une première démonstration impressionnante, beaucoup d’utilisateurs se posent la même question : que deviennent les fichiers que je viens d’importer ? C’est la bonne question. Pour vous répondre, une application multimodale peut transmettre vos textes, images et documents à un ou plusieurs fournisseurs de modèles. Une politique de confidentialité qui ne décrit que l’application, sans rien dire de ces fournisseurs, laisse dans l’ombre le maillon le plus important de la chaîne.
Le cadre juridique vous donne des points précis à examiner. La CNIL, l’autorité française de protection des données, rappelle que le droit à l’effacement prévu par le RGPD figure à l’article 17 et peut imposer la suppression de données dans certaines circonstances. Elle précise aussi que l’exercice des droits sur les jeux de données d’entraînement peut poser des difficultés comparables à celles d’autres grands ensembles de données, tandis que l’exercice de ces mêmes droits sur un modèle d’IA soulève des difficultés techniques supplémentaires. Les engagements relatifs à la suppression et à l’entraînement doivent donc reposer sur des dispositions opérationnelles explicites, et non sur de vagues assurances.
Des engagements à vérifier, pas à tenir pour acquis
Considérez les déclarations des fournisseurs, y compris les nôtres, comme des engagements à confronter à une politique écrite. Nous sommes une entreprise française, avec un hébergement dans l’Union européenne. Notre service est conforme au RGPD, nous avons des accords de non-conservation des données avec tous les fournisseurs de modèles d’IA avec lesquels nous travaillons, et nous n’utilisons ni les conversations ni les fichiers des utilisateurs pour entraîner des IA. Vous pouvez lire le texte complet de notre politique de confidentialité et juger s’il répond aux questions ci-dessous.
Chaque engagement répond à un point précis, mais en laisse d’autres ouverts. Les accords de non-conservation précisent si les fournisseurs gardent vos données après leur traitement. L’exclusion de l’entraînement précise si vos fichiers servent à améliorer de futurs modèles. Aucun de ces engagements ne suffit, à lui seul, à expliquer comment fonctionne la suppression de données déjà traitées par un fournisseur, ni combien de temps les sauvegardes persistent. Un lecteur attentif continue donc de poser des questions jusqu’à obtenir des réponses sur ces points.
Posez quatre questions à tout fournisseur avant d’importer un contrat, une facture ou un document contenant des données personnelles.
- Où les données sont-elles hébergées : dans quel pays ou quelle région vos fichiers et conversations sont-ils stockés au repos ?
- Qui les traite : quels fournisseurs de modèles reçoivent votre contenu lorsque vous posez une question ?
- Sont-elles conservées : les accords en vigueur interdisent-ils à ces fournisseurs de les stocker ou de les utiliser pour l’entraînement ?
- Puis-je les supprimer moi-même : votre profil dispose-t-il d’une commande permettant d’effacer vos données sans contacter l’assistance ?
Un fournisseur qui répond par écrit aux quatre questions prend des engagements sur lesquels vous pouvez vous appuyer. Un fournisseur qui se contente de dire qu’il « prend la confidentialité au sérieux » n’en fait pas autant.
Choisir l’application d’IA multimodale adaptée à votre travail
Partez de votre semaine type, pas d’un comparatif de fonctionnalités. La bonne application dépend des fichiers que vous manipulez, du nombre de modèles auxquels vous souhaitez accéder, de la sensibilité de vos documents et de ce que vous payez déjà pour vos outils d’IA.
Les questions à trancher en premier
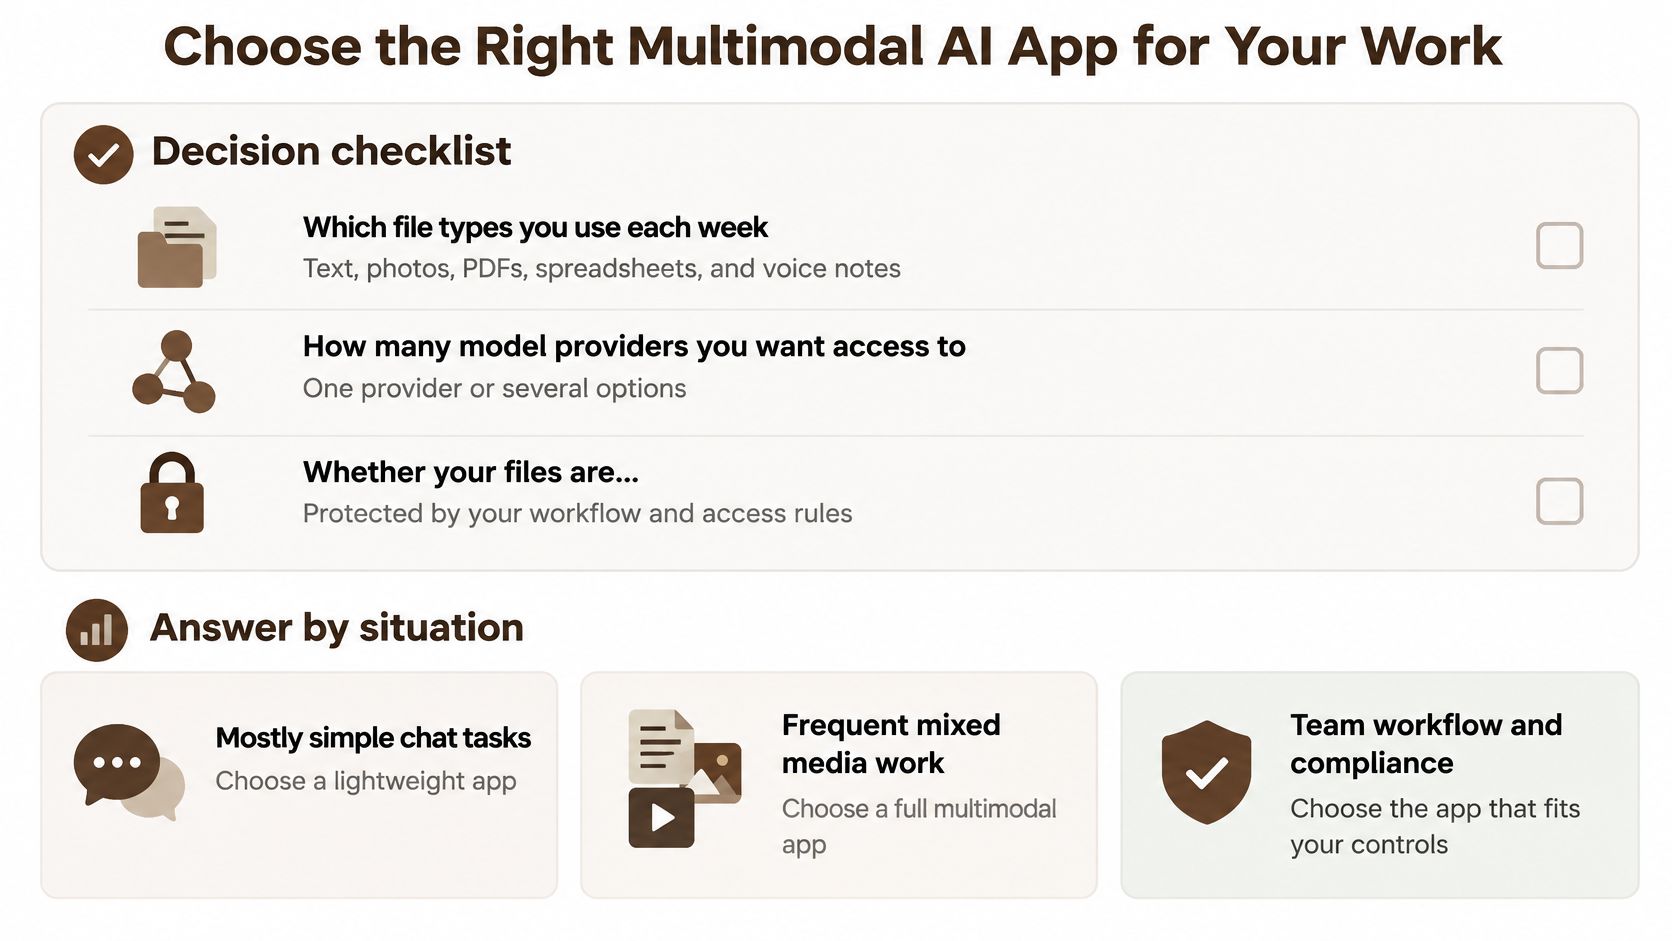
- Quels formats utilisez-vous chaque semaine : si vous posez surtout des questions au clavier, une application légère peut suffire. Si vous travaillez régulièrement avec des PDF, des tableurs et des photos, une application d’IA multimodale complète sera plus adaptée.
- À combien de fournisseurs de modèles souhaitez-vous accéder : un fournisseur de confiance peut suffire. Vous pouvez aussi en vouloir plusieurs, car tous les modèles ne traitent pas de la même façon les graphiques, le code et les longs documents.
- Vos fichiers sont-ils sensibles : les contrats et les factures exigent davantage de garanties de confidentialité, selon la liste précédente. C’est rarement le cas des diapositives de cours.
- Combien payez-vous déjà : additionnez vos abonnements d’IA actuels avant de les comparer à une offre groupée.
Le choix du modèle mérite que l’on s’y attarde, car il influence la qualité des réponses au quotidien. Le routage automatique dirige chaque question vers le modèle d’IA le mieux adapté. Vous n’avez donc pas à deviner lequel traitera le mieux un graphique ou un long PDF. Ce choix ne vous est pas imposé : vous pouvez le modifier à tout moment dans le sélecteur de modèles, même en cours de conversation. BromeAI réunit ChatGPT, Claude, Gemini, Mistral et d’autres modèles d’IA sur une même plateforme européenne. Vous accédez ainsi à plusieurs fournisseurs depuis ce sélecteur, sans créer un compte chez chacun.
Ce que la comparaison des prix dit vraiment
| Option | Coût mensuel | Facturation |
|---|---|---|
| Cinq abonnements d’IA distincts | environ 88 € | une facture par fournisseur |
| Brome Plus | 24,90 € | une facture unique pour le même éventail de modèles |
Cinq abonnements d’IA distincts coûtent environ 88 € par mois, contre 24,90 € pour Brome Plus, qui donne accès au même éventail de modèles sur une facture unique. Cette comparaison n’a de sens que si vous utilisez réellement plusieurs modèles. Si votre travail n’en nécessite qu’un seul, comparez plutôt l’offre individuelle de son fournisseur : la formule groupée ne sera pas forcément plus avantageuse. Un calcul honnête vaut mieux qu’une économie affichée en gros caractères.
Terminez par un test que vous pouvez faire cette semaine. Choisissez trois vrais fichiers de votre travail, idéalement un document comportant un total à recalculer et un autre contenant une clause ou une note importante. Posez la même question en mode automatique, puis avec un modèle choisi manuellement. Vérifiez ensuite une réponse dans la page ou la cellule source. L’application qui passe ce test sur vos fichiers est la bonne, quel que soit son discours marketing.
Importez vos trois fichiers de test dans BromeAI et analysez-les dans une même conversation : laissez le routage automatique choisir le modèle ou sélectionnez-le vous-même. Grâce aux accords de non-conservation des données conclus avec chaque fournisseur, vos contrats, factures et tableurs ne servent pas à l’entraînement des modèles. Vous pouvez ainsi tester l’outil sur de vrais documents plutôt que sur des exemples fictifs. Commencez par le total d’une facture que vous connaissez déjà, vérifiez la réponse dans votre tableur, puis décidez sur pièces plutôt que sur promesses.