Systèmes multi-agents : comment les modèles IA collaborent
Un système de type « mixture of agents » fait intervenir plusieurs modèles ou agents d’IA sur une même tâche, puis réunit leurs productions en un seul résultat. Si trois modèles s’accordent sur une réponse, cet accord la rend-il plus fiable ? Ou révèle-t-il simplement un angle mort commun aux trois ?
La question mérite d’être posée : ajouter des agents est facile à expliquer, mais plus difficile à justifier. Chaque modèle supplémentaire consomme des tokens, augmente la latence et crée une nouvelle possibilité d’erreur. Ce surcoût ne se justifie que si chaque membre apporte une contribution distincte et si une étape finale sait distinguer un travail solide d’une réponse erronée formulée avec assurance. Considérez cette architecture comme une hypothèse à tester face à un modèle unique performant, pas comme une amélioration acquise.
Sommaire
- Ce qu’est un système multi-agents et d’où vient cette approche
- Comment les agents se transmettent le travail entre les couches
- Choisir l’architecture adaptée à votre tâche
- Exemples concrets : recherche et traitement documentaire
- Les défaillances des systèmes multi-agents et comment les contenir
- Confidentialité et gouvernance à chaque transfert
- Vérifier l’intérêt d’un système multi-agents avant de le construire
Ce qu’est un système multi-agents et d’où vient cette approche
Un système de type mixture of agents, ou système multi-agents, fait intervenir plusieurs modèles ou agents d’IA qui prennent chacun en charge une partie d’une tâche. Une étape finale réunit ensuite leurs productions en un seul résultat. Imaginez une petite équipe de cinéma travaillant sur une scène. Un documentaliste trouve les sources, un scénariste rédige le texte et un monteur examine le tout pour décider de ce qui sera conservé. Personne n’assume tous les rôles, et le monteur peut écarter ce qui ne tient pas la route.
Cette équipe repose sur trois éléments que l’on retrouve dans tout système de ce type : des membres spécialisés qui effectuent le travail, un mécanisme pour leur distribuer les tâches et un autre pour réunir leurs productions. Si l’un de ces éléments manque, vous n’avez pas un système multi-agents, mais plusieurs conversations sans lien entre elles.
Deux approches derrière un même terme
Le terme recouvre deux architectures proches. Dans un ensemble à l’inférence, plusieurs modèles de langage répondent séparément à la même question, puis un autre modèle fusionne leurs réponses. Dans une architecture avec routage, le système choisit le modèle adapté à chaque demande : une question chiffrée est envoyée à un modèle, une question de formulation à un autre. Les deux approches répartissent le travail, mais la première fait fonctionner plusieurs membres en parallèle sur la même entrée, tandis que la seconde dirige chaque entrée vers un membre sélectionné.
Un chatbot unique qui utilise une calculatrice ou un outil de recherche n’est pas un système multi-agents : un seul composant y assure le raisonnement.
Cette distinction prête souvent à confusion. Un outil renvoie des données ; un agent les interprète, rédige ou porte un jugement. Un système multi-agents a besoin de plusieurs de ces composants de raisonnement, ainsi que d’une étape de synthèse. Si vous cartographiez votre propre organisation dans un espace de travail IA, comptez les composants qui raisonnent sur la tâche, pas les outils qu’ils utilisent.
Un principe ancien, de nouveaux composants
L’approche moderne remonte à l’article de 1991 Adaptive Mixtures of Local Experts. Il associait des réseaux neuronaux spécialisés à un réseau de sélection entraîné pour confier chaque cas à l’expert le mieux adapté. Selon la présentation des mélanges d’experts par IBM, ce dispositif expérimental atteignait la précision visée en deux fois moins d’époques d’entraînement qu’un modèle classique comparable. Imaginez un service d’assistance où chaque ticket est transmis au spécialiste concerné, plutôt qu’à un généraliste chargé de tout traiter. Le réseau de sélection jouait le rôle de la personne qui trie les demandes à l’accueil.
Des travaux ultérieurs ont fait évoluer ce principe vers le routage parcimonieux : seuls quelques experts sont activés pour chaque entrée, ce qui réduit les calculs nécessaires par exemple traité. Les composants ont radicalement changé depuis 1991 : les membres actuels sont des modèles de langage complets, et non de petits réseaux. Le principe, lui, reste identique : répartir le travail, orienter chaque partie vers le spécialiste approprié et réunir les résultats.
Avant de poursuivre, faites un petit exercice. Dressez la liste des intervenants d’un processus que vous utilisez déjà, même si vous vous contentez de copier du texte entre deux fenêtres de conversation. Demandez-vous si chacun a un rôle distinct que vous pourriez décrire en une phrase. Si deux membres font le même travail de la même manière, l’un d’eux ajoute probablement un coût sans apporter de jugement supplémentaire.
Comment les agents se transmettent le travail entre les couches
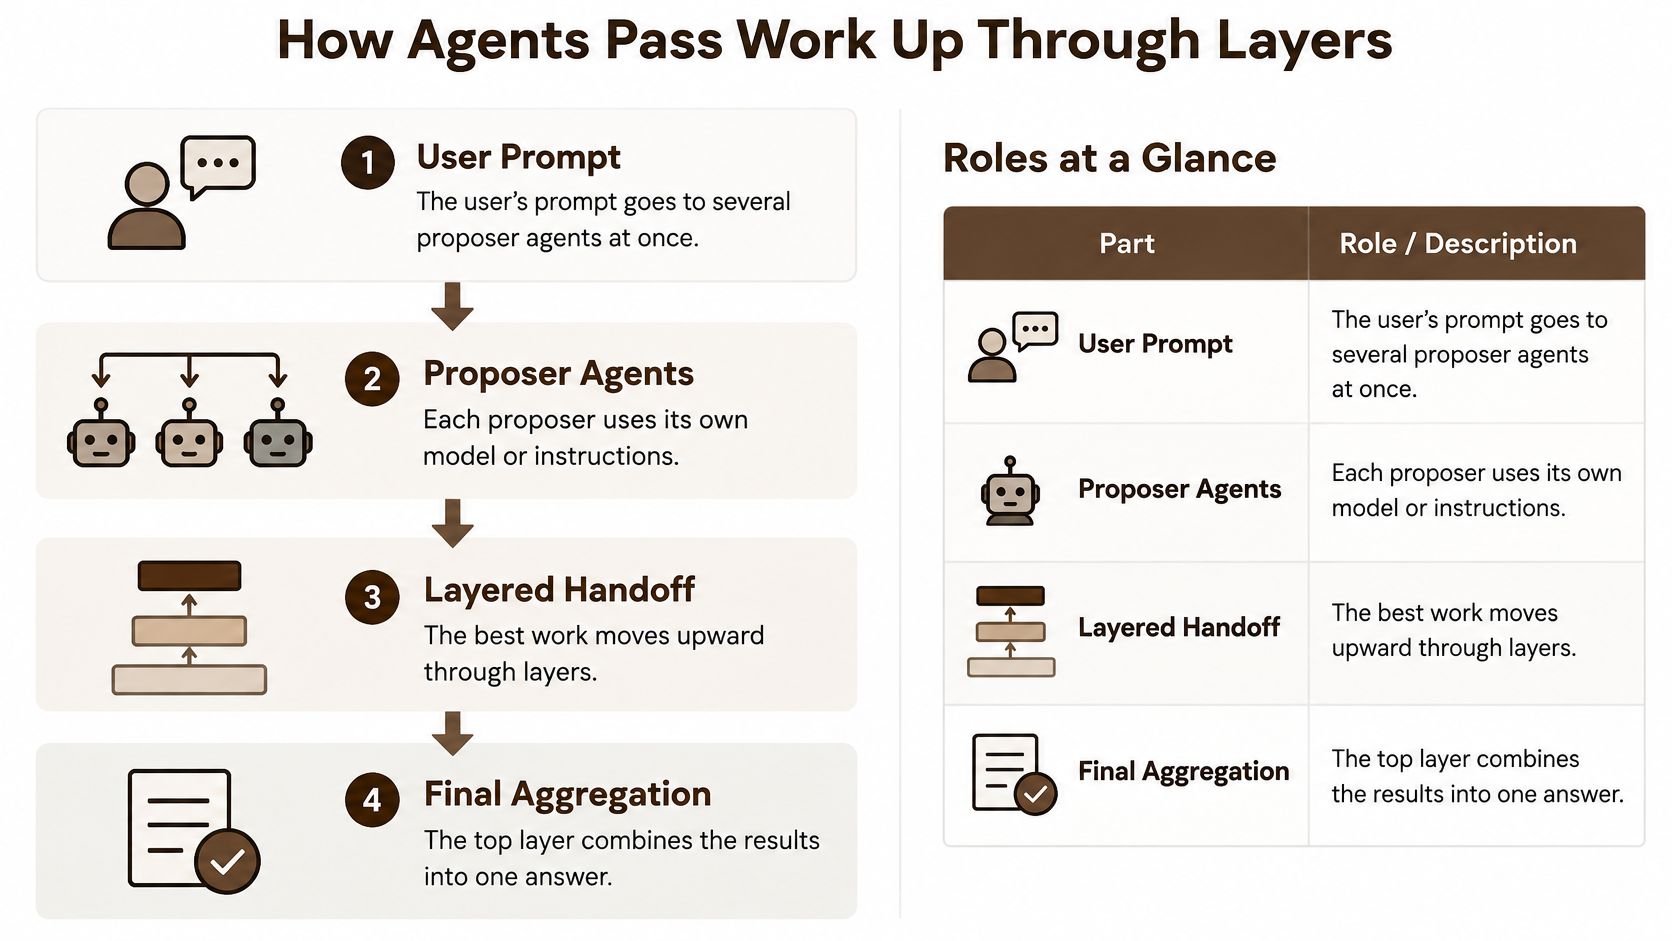
Dans un système multi-agents, le travail progresse à travers des étapes définies, chacune ayant sa raison d’être. Le schéma ci-dessous présente le parcours de la consigne à la réponse finale. Lisez-le de haut en bas, puis examinez chaque étape à l’aide du tableau qui suit.
Les cinq étapes, dans l’ordre
- La consigne est distribuée. Votre consigne est envoyée simultanément à plusieurs agents proposant une réponse, chacun utilisant son propre modèle ou ses propres instructions. Grâce à cette exécution en parallèle, le temps d’attente dépend du plus lent, et non de la somme des temps de tous les agents.
- Chaque agent répond seul. Chacun renvoie une réponse candidate, accompagnée de sa justification ou de ses sources. Cette indépendance est essentielle : les agents qui lisent trop tôt les brouillons des autres ont tendance à converger vers la première réponse plausible.
- L’agrégateur fait la synthèse. Un agrégateur reçoit toutes les propositions et rédige une réponse unique. Il les pondère selon la solidité de leurs éléments à l’appui, plutôt que de compter les voix. L’erreur classique consiste à reprendre le brouillon au ton le plus assuré, ce qui annule tout l’intérêt du collectif.
- Des couches facultatives affinent le résultat. Une couche supplémentaire peut relire la synthèse et l’améliorer, comme le ferait un second éditeur. Le risque est que chaque nouvelle couche répète une erreur de la précédente avec une assurance renouvelée. L’affinage n’est donc utile que si les agents vérifient les sources, au lieu de se valider mutuellement.
- Un vérificateur contrôle la sortie. Un agent critique ou vérificateur confronte la réponse finale aux sources ou aux règles avant toute utilisation. Sans cette étape, des erreurs bien formulées passent le contrôle avec toute l’autorité apparente du collectif.
| Rôle | Mission principale | Élément transmis |
|---|---|---|
| Agent proposant une réponse | Rédiger une réponse ou une analyse selon son propre angle | Une proposition accompagnée de notes justificatives |
| Agrégateur | Réunir les propositions en une réponse | Une synthèse unique |
| Agent critique ou vérificateur | Confronter les affirmations aux sources ou aux règles | Validation, rejet ou demande de révision |
| Routeur | Choisir le modèle ou l’agent chargé de chaque demande | Une décision de routage pour chaque sous-tâche |
Le coût de chaque couche supplémentaire
Chaque couche ajoutée consomme des tokens et du temps. L’agrégateur doit lire toutes les propositions : son entrée s’allonge donc à chaque membre supplémentaire. Une deuxième couche d’affinage relit l’ensemble et produit un nouveau brouillon complet. Vous payez ainsi plusieurs réponses complètes pour n’en obtenir qu’une. Cela peut être raisonnable pour une question difficile, mais inutile pour une demande simple.
Règle pratique : si vous ne pouvez pas préciser la contribution de chaque agent ni montrer d’où vient la réponse finale, votre système n’est qu’une boîte noire avec des étapes en plus.
Appliquez ce test à tout système que vous examinez. Demandez quel agent a produit une affirmation précise de la réponse finale. Si personne ne peut en retracer l’origine, l’empilement des couches masque les problèmes au lieu de les résoudre.
Choisir l’architecture adaptée à votre tâche
Commencez par une question : votre tâche se décompose-t-elle en parties indépendantes, ou forme-t-elle une chaîne dans laquelle chaque étape dépend de la précédente ? Cette seule distinction détermine l’essentiel du choix d’architecture. Les parties indépendantes se prêtent aux agents en parallèle ; les étapes en chaîne, beaucoup moins.
| Structure de la tâche | Architecture adaptée | Pourquoi elle convient | Risque principal |
|---|---|---|---|
| Sources indépendantes à examiner en parallèle | Plusieurs agents proposant des réponses à un agrégateur | Chaque agent lit des documents différents et l’agrégateur réunit leurs constats | Erreurs corrélées lorsque les agents partagent un angle mort |
| Étapes dépendant chacune de la précédente | Agent unique ou orchestrateur avec transmissions ordonnées | Les étapes suivantes ont besoin des résultats vérifiés des précédentes | Les agents en parallèle multiplient une erreur initiale |
| Réponse unique à fort enjeu, par exemple sur une clause contractuelle | Plusieurs générations du modèle le plus performant, avec un vérificateur | La diversité ajoute du bruit lorsqu’un modèle est nettement supérieur | Le consensus peut renforcer une interprétation erronée |
| Tâches nécessitant des outils ou des connaissances différents | Ensemble de modèles spécialisés avec routage | Le routeur confie chaque sous-tâche au modèle adapté | Une erreur de routage envoie le travail au mauvais modèle |
| Rédaction créative admettant plusieurs bonnes réponses | Agents organisés en couches, avec un agrégateur qui combine les brouillons | La variété des styles enrichit le texte final | L’agrégateur peut uniformiser les voix |
Le tableau, ligne par ligne
Lorsque les sources sont indépendantes, plusieurs agents alimentant un agrégateur fonctionnent bien : chacun lit des documents différents et les désaccords apportent de l’information. Lorsque les étapes dépendent les unes des autres, un agent unique ou un orchestrateur avec des transmissions ordonnées convient mieux. Une étape ultérieure doit en effet s’appuyer sur un résultat vérifié, et non sur une hypothèse formulée en parallèle. Pour une réponse unique à fort enjeu, générer plusieurs réponses avec le meilleur modèle et ajouter un vérificateur donne souvent de meilleurs résultats que d’intégrer des modèles plus faibles, qui ajoutent surtout du bruit.
Les systèmes avec routage conviennent aux tâches exigeant des outils ou des connaissances variés. C’est le principe du routage automatique des modèles, qui dirige chaque question vers un modèle approprié. La rédaction créative laisse davantage de marge : plusieurs réponses peuvent être valables, et des brouillons variés offrent une matière utile à l’agrégateur. Pour approfondir le passage à l’échelle de ces schémas en production, le guide de Cyndra sur la conception d’architectures multi-agents évolutives détaille les choix d’orchestration sous l’angle de l’ingénierie.
Pourquoi la diversité n’est pas toujours un atout
Les résultats des évaluations vont dans les deux sens, d’où l’importance des tests. Dans l’étude de référence initiale sur Mixture-of-Agents, un système en couches a atteint un taux de victoire de 65,8 % sur AlpacaEval 2.0, contre 57,5 % pour le meilleur système précédent, GPT-4 Omni. Pourtant, une étude NeurIPS sur Self-MoA a montré que l’agrégation de plusieurs réponses d’un seul modèle très performant dépassait le MoA standard, qui combine différents LLM, de 6,6 % sur AlpacaEval 2.0 et de 3,8 % en moyenne sur MMLU, CRUX et MATH.
Considérez donc la diversité des modèles comme une hypothèse à valider, pas comme un avantage acquis. Exécutez la même tâche avec plusieurs modèles différents, puis avec plusieurs réponses de votre meilleur modèle, en conservant le même budget de tokens et de coût. Comparez l’exactitude et examinez la nature des désaccords entre les propositions : un désaccord utile ne ressemble pas à une simple variation aléatoire.
Dernier point de conception : demandez à l’agrégateur de pondérer les propositions selon les éléments probants, et non par vote majoritaire. Trois agents peuvent partager une même hypothèse fausse ; un vote transforme alors cette erreur commune en réponse finale assurée.
Exemples concrets : recherche et traitement documentaire
Les architectures abstraites deviennent plus claires lorsqu’on les applique à des tâches précises. Chaque scénario ci-dessous décrit les intervenants, les transmissions et le résultat vérifiable. Chaque exemple présente aussi une défaillance et le correctif qui permet de la contenir.
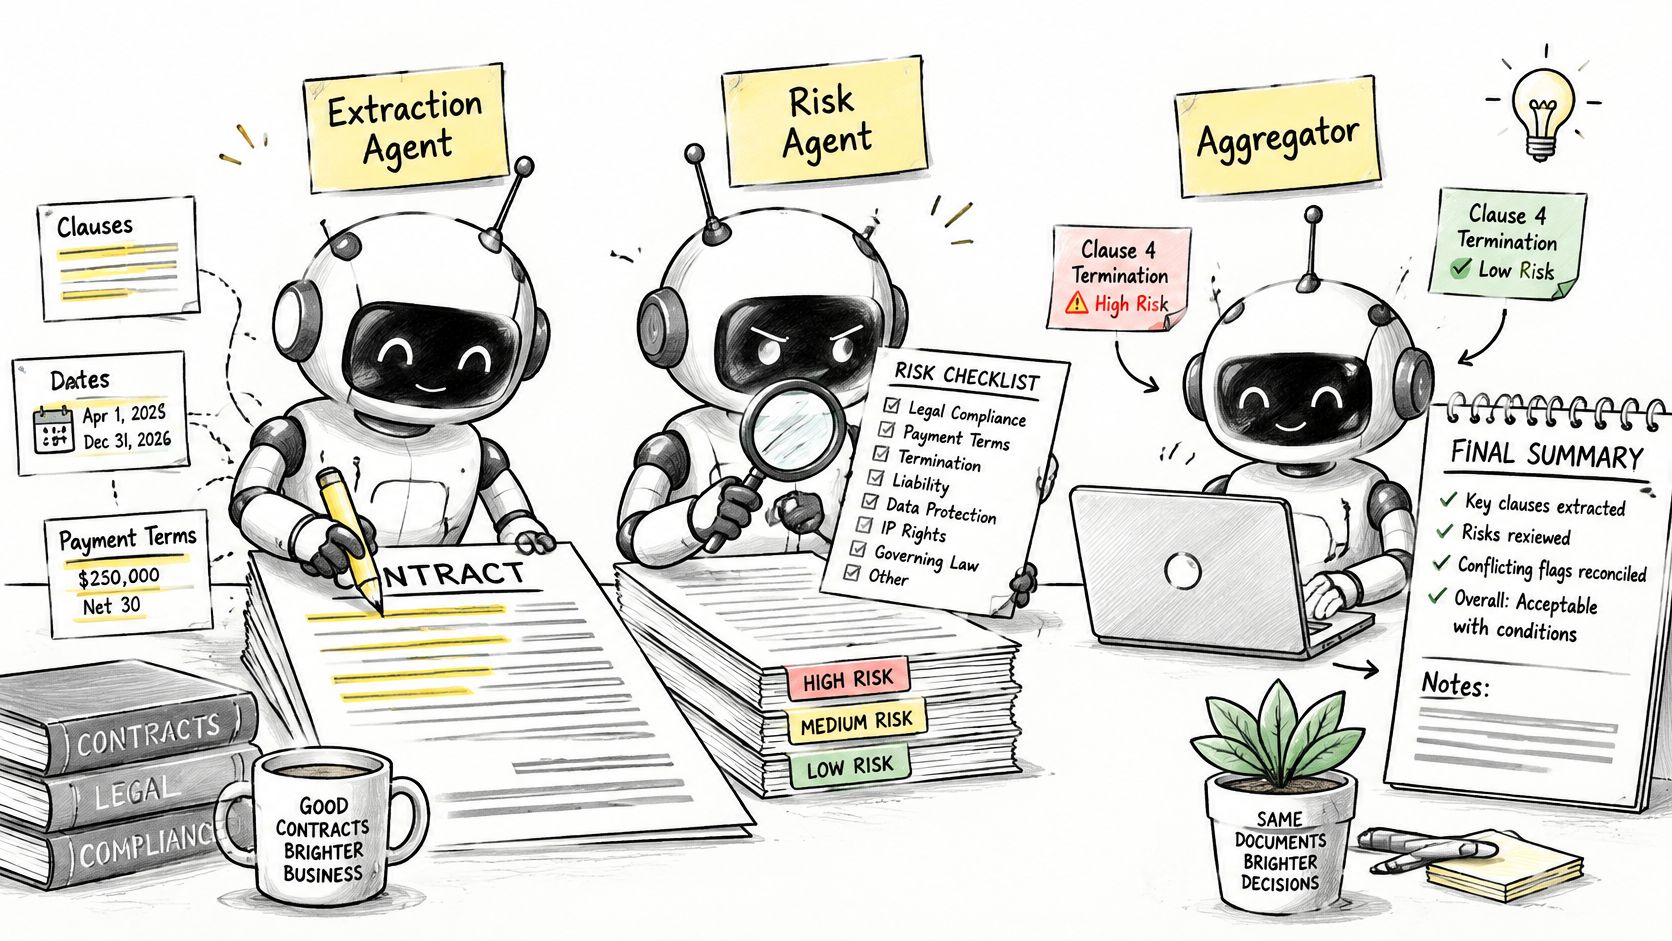
Analyser un contrat avec trois rôles définis
Imaginons qu’une équipe juridique examine un contrat fournisseur avant signature. Un agent d’extraction rassemble les clauses, les dates et les modalités de paiement dans une liste structurée. Un agent d’analyse des risques vérifie chaque clause à l’aide d’une grille couvrant la responsabilité, la résiliation et le renouvellement. Un agrégateur rapproche les signalements contradictoires et rédige une synthèse citant les numéros des clauses, afin qu’un juriste puisse vérifier chaque affirmation en quelques minutes.
Le problème apparaît lorsque deux agents signalent la même clause pour la même mauvaise raison, par exemple en prenant une limitation courante pour une disposition inhabituelle. Dans la synthèse, leur accord semble constituer un élément solide. La solution consiste à exiger que chaque agent cite le texte source sur lequel il s’appuie. Un consensus douteux devient alors vérifiable ligne par ligne. C’est dans ce type de contrôle, clause par clause, qu’une analyse documentaire structurée portant sur l’intégralité du fichier prend tout son intérêt.
Rédiger une note de recherche à partir de sources
Supposons maintenant qu’un chercheur ait besoin d’une courte note sur un sujet controversé. Un agent de recherche documentaire rassemble les sources et en consigne la provenance. Un agent de lecture résume chaque source séparément et joint des références à chaque résumé. Un agent de synthèse rédige la note à partir de ces résumés et signale les affirmations peu étayées, au lieu de gommer les incertitudes.
Le résultat vérifiable est une note dont chaque paragraphe renvoie à des sources identifiées. Lorsque deux sources se contredisent, l’agent de synthèse le signale plutôt que de trancher seul. Cette pratique compte davantage que l’élégance du style : le lecteur peut ainsi apprécier lui-même les éléments disponibles.
Vérifier des factures et proposer des titres
Pour le traitement de factures et de feuilles de calcul, un routeur envoie les questions principalement chiffrées à un modèle adapté aux tableaux, et les questions de formulation à un modèle de rédaction. Ici, l’échec prend la forme d’une demande mal orientée qui reçoit une réponse bien écrite, mais fausse sur les chiffres. La solution consiste à consigner chaque décision de routage, pour repérer les questions qui arrivent régulièrement au mauvais modèle et ajuster les règles.
Une réponse fluide du mauvais modèle est plus dangereuse qu’une réponse maladroite du bon modèle, car personne ne pense à la vérifier.
L’exemple le plus léger est celui d’une sélection de titres pour un article ou une campagne. Plusieurs agents proposent des variantes dans des styles différents, puis l’agrégateur combine les meilleurs éléments dans une liste restreinte. Un humain peut facilement en juger la qualité, et un assemblage médiocre ne coûte que quelques secondes. Ce faible risque fait des sélections créatives un bon terrain d’apprentissage avant de confier des contrats à l’agrégation. Quelle que soit la tâche, passez le résultat au crible de la liste de contrôle de la dernière section avant de l’utiliser.
Les défaillances des systèmes multi-agents et comment les contenir
La défaillance la plus courante est l’erreur corrélée. Des agents entraînés sur des données similaires partagent souvent les mêmes idées fausses. Ils s’accordent alors sur une réponse erronée, et cet accord ressemble à s’y méprendre à de la fiabilité. Un collectif ne vous protège pas si tous ses membres ont appris la même erreur. Ajouter un deuxième agent donne l’impression d’obtenir un second avis. Souvent, cela ne fait que reproduire la première erreur.
Quatre autres causes d’échec
- L’amplification des erreurs. Des agents indépendants travaillant sans vérification croisée peuvent laisser une erreur initiale se propager dans toutes les branches. Dans l’étude de Google Research portant sur 180 configurations d’agents, les agents indépendants ont amplifié les erreurs jusqu’à 17,2 fois, contre 4,4 fois dans les systèmes centralisés dotés d’un orchestrateur.
- La mise en parallèle d’un travail séquentiel. Lorsque chaque étape a besoin du résultat précédent, les agents en parallèle s’appuient sur des suppositions non vérifiées, ce qui dégrade la réponse finale.
- L’accumulation des coûts et de la latence. Chaque couche ajoutée lit et réécrit le travail des précédentes : sur les tâches simples, les réponses deviennent lentes et coûteuses sans gain de qualité.
- Les erreurs de routage. Un routeur qui classe mal une demande l’envoie au mauvais modèle, lequel renvoie une réponse fluide, assurée et fausse.
La leçon générale de ces travaux est que le choix d’architecture peut découler de la structure de la tâche, plutôt que de l’intuition. La coordination a amélioré les tâches parallélisables et nui aux tâches séquentielles. Considérez chaque agent supplémentaire comme une hypothèse à tester face à une solution de référence plus simple, pas comme un progrès automatique. C’est la structure de la tâche, et non le nombre d’agents, qui détermine le résultat.
Des contrôles pour limiter les dégâts
Associez à chaque défaillance un contrôle adapté. Limitez le nombre de couches pour éviter que l’affinage ne tourne à la répétition sans fin. Exigez que chaque agent cite ses sources et consignez quel agent a produit chaque affirmation. Donnez à un vérificateur le pouvoir effectif de rejeter une réponse, et imposez une validation humaine pour les résultats juridiques, financiers ou médicaux. Pour approfondir la détection des problèmes lors des transmissions entre agents, le guide d’IamVera.AI sur la surveillance des transferts dans les systèmes d’IA multi-agents examine les cascades d’erreurs à chaque point de passage.
Ces contrôles s’inscrivent dans des pratiques établies de gestion des risques. Le National Institute of Standards and Technology américain a publié son profil consacré à l’IA générative le 26 juillet 2024, en complément de l’AI Risk Management Framework. Son approche de la confiance couvre notamment la validité et la fiabilité, la responsabilité et la transparence, ainsi que l’explicabilité. Dans cette perspective, traitez votre système multi-agents comme un système soumis à une gouvernance, et non comme une fenêtre de discussion. Soyez aussi attentif au signal d’alerte précoce : si deux agents sont d’accord sans citer de source commune, considérez cet accord comme non vérifié jusqu’à ce qu’un contrôle soit effectué.
Confidentialité et gouvernance à chaque transfert
La promesse d’un fournisseur de ne pas utiliser vos fichiers pour entraîner un modèle ne couvre qu’une relation avec un prestataire. Un système multi-agents multiplie ces relations. Lorsqu’un planificateur transmet le même document à deux agents de recherche, puis à un rédacteur et enfin à un vérificateur, ce document existe sous forme de copie distincte dans chaque contexte, avec des durées de conservation et des règles d’accès différentes. Ces transmissions ressemblent à une chaîne de traçabilité des preuves : chaque transfert crée une trace à attester, et l’ensemble ne vaut que par son maillon le moins rigoureux.
À chaque étape, les questions sont donc très concrètes. Où cette copie est-elle stockée ? Qui peut la lire chez ce fournisseur ? Combien de temps est-elle conservée ? Qu’est-ce qui déclenche sa suppression ? Un responsable des opérations sait généralement répondre pour le prestataire choisi délibérément par l’entreprise, mais pas pour ceux que le routage a sollicités en son nom.
Ce que demandent vraiment les cadres de gouvernance
Le profil du NIST consacré à l’IA générative présente la gouvernance comme une fonction transversale, et non comme une validation finale. Parmi les fonctions fondamentales de l’AI Risk Management Framework, la fonction Measure demande que les modèles et systèmes d’IA soient expliqués, validés et documentés, et que leurs résultats soient interprétés dans leur contexte. Pour un système multi-agents, cela implique un journal précisant quel agent a traité chaque demande, ce qu’il a reçu et comment sa production a été évaluée, y compris la décision de routage qui l’a orientée vers lui.
Si vous ne pouvez pas fournir une trace des modèles ayant reçu un document, vous ne pouvez pas prouver comment ce document a été traité.
Le manque d’observabilité revient régulièrement dans la pratique. Une revue de la littérature sur l’IA agentique relève parmi ses faiblesses majeures les déficits de fiabilité, les lacunes de gouvernance, ainsi que l’insuffisance des mécanismes d’observation ou d’arrêt sûr. Traduisez ces constats en décisions avant la première exécution : qui peut révoquer l’autorisation d’utiliser un outil en cours de tâche ? Qu’est-ce qui arrête une couche qui continue à affiner sa réponse ? Où le journal d’exécution sera-t-il conservé ?
Le droit à l’effacement avec plusieurs fournisseurs
L’effacement ajoute une dimension juridique à la gestion opérationnelle. Selon les orientations de l’Union européenne sur la protection des données et le RGPD, le droit à l’effacement est conditionnel, et non absolu. Les organisations peuvent refuser une suppression lorsque la conservation est nécessaire au respect d’une obligation légale, à l’intérêt public, à la recherche, à l’archivage ou à la défense de droits en justice. Elles doivent généralement répondre dans un délai maximal d’un mois après la demande. Un bouton de suppression dans une interface lance ce processus ; il ne l’achève pas.
Les copies transmises en aval compliquent la situation. La FAQ du Comité européen de la protection des données explique que, lorsque des données concernées par une demande d’effacement ont été transmises à d’autres organisations, le responsable du traitement doit en informer ces destinataires, sauf si cela est impossible ou exige des efforts disproportionnés. Une même conversation passant par un routage automatique ou un changement manuel de modèle peut atteindre plusieurs fournisseurs. La liste des destinataires s’allonge donc à chaque couche ajoutée.
Le test d’utilité devient ici un test de gouvernance. Chaque agent supplémentaire offre une chance d’améliorer le résultat, mais ajoute un destinataire à identifier, une politique de conservation à vérifier et une partie à notifier. Dressez la liste de tous les fournisseurs susceptibles de recevoir une demande et précisez comment chacun serait informé d’une demande d’effacement. Si cette liste comporte des zones d’ombre, l’architecture n’est pas prête à recevoir les données que vous comptez lui confier.
Vérifier l’intérêt d’un système multi-agents avant de le construire
Le système justifie-t-il son surcoût sur vos tâches ? Une comparaison rigoureuse peut suffire à le déterminer, sans vaste expérimentation. Suivez ces six étapes dans l’ordre et laissez les résultats primer sur vos hypothèses.
- Décrivez la tâche en une phrase. Précisez si ses sous-tâches sont indépendantes ou en chaîne. Les sous-tâches indépendantes peuvent être exécutées en parallèle, et un deuxième modèle peut repérer une omission. Les sous-tâches en chaîne transmettent leur résultat d’un agent au suivant : une erreur initiale peut donc remonter les couches en gagnant en assurance.
- Précisez la contribution de chaque agent. Si vous ne pouvez pas expliquer ce qu’un membre apporte, retirez-le et utilisez plutôt un seul modèle performant.
- Fixez un budget avant de commencer. Définissez le nombre de tokens, la latence et le coût acceptables par réponse, pour que le système multi-agents ne puisse pas gagner simplement en dépensant davantage.
- Testez les deux architectures sur des exemples réels. Comparez le système multi-agents à une référence utilisant un seul modèle sur une vingtaine d’exemples issus de votre travail, avec le même budget.
- Comparez l’exactitude et vérifiez les références. Confrontez chaque citation à sa source. Si plusieurs agents s’accordent sur la même référence erronée, leur accord ne constitue pas une preuve.
- Désignez un responsable de la validation humaine. Tout résultat ayant des conséquences juridiques, financières ou médicales doit être approuvé avant utilisation par une personne nommément désignée.
C’est à la quatrième étape que beaucoup de comparaisons se faussent. Un système multi-agents peut sembler meilleur parce qu’il consomme plus de tokens ou multiplie les tentatives. Gardez le budget constant, puis comparez-le à votre meilleur modèle unique sur les mêmes exemples. À la cinquième étape, notez si le système a détecté des erreurs manquées par le modèle unique ou s’il les a répétées. Ce relevé vous indiquera si vous ajoutez un jugement indépendant ou si vous amplifiez l’erreur d’un modèle.
Passez à la comparaison cette semaine. BromeAI réunit ChatGPT, Claude, Gemini, Mistral et d’autres modèles sur une même plateforme européenne. Vous pouvez ainsi soumettre la même tâche à plusieurs modèles dans un espace de travail unique et changer de modèle sans perdre votre conversation. Choisissez une tâche réelle de votre activité et vérifiez si un système multi-agents fait mieux que votre meilleur modèle unique. Si ce n’est pas le cas, un seul modèle performant reste la meilleure architecture.