Analyse de données avec l’IA : préparer et vérifier
Vous avez exporté le fichier des ventes du mois dernier en fin d’après-midi, saisi un court prompt et obtenu un paragraphe bien construit sur les produits en perte de vitesse. Le graphique est clair. Les pourcentages semblent précis. Puis un collègue vous demande quelles lignes ont servi au calcul du taux. Et là, impossible de lui montrer un script, un instantané des données, ni même le fichier exact que vous avez importé.
C’est à ce moment-là que l’analyse de données avec l’IA cesse de ressembler à un raccourci et devient une affirmation que vous devez pouvoir justifier. Une synthèse convaincante n’est pas un résultat que quelqu’un d’autre pourra reproduire mardi prochain. La méthode ci-dessous considère chaque sortie du modèle comme une affirmation qui exige une piste d’audit, une personne chargée de la vérifier et une validation formelle, pas seulement comme une réponse rapide.
Vous n’avez pas besoin de nouveaux outils pour commencer. Il vous faut un fichier daté, une question écrite, du code exécutable et une personne responsable de l’interprétation. Les contrôles qui suivent sont ceux que vous devriez pouvoir expliquer à un collègue avant qu’un chiffre ne sorte de l’équipe.
Sommaire
- Quelles étapes de l’analyse confier à l’IA
- Confidentialité : les vérifications avant tout import
- Préparer vos données avant de rédiger un prompt
- Demander à l’IA du code plutôt que des conclusions
- Vérifier les résultats de l’IA avant de s’y fier
- Quand l’IA doit passer le relais aux experts
- Tester la méthode sur un rapport récurrent
Quelles étapes de l’analyse confier à l’IA
Les équipes confient souvent le jugement au modèle et gardent la saisie pour elles. C’est l’inverse qu’il faut faire. Un modèle est utile pour les tâches mécaniques : corriger des types de données, écrire une jointure ou esquisser un premier graphique. Il l’est beaucoup moins pour déterminer ce qui constitue une preuve.
Une analyse de la Federal Reserve Bank of St. Louis indique que 28 % des travailleurs utilisaient, à des degrés divers, l’IA générative au travail. Parmi eux, 33,0 % déclaraient avoir gagné une heure ou moins au cours de la semaine précédente. Cette même analyse estimait à 1,1 % le gain de productivité global et à 33 %, en moyenne, le gain de productivité des travailleurs pendant les heures où ils utilisaient l’IA générative. Ces chiffres reposent sur des déclarations : ils ne constituent donc pas une promesse de rendement. Ils montrent néanmoins où se situe le gain de temps : dans l’extraction d’informations, l’organisation des données et la rédaction de synthèses, pas dans le remplacement de l’analyste.
Les équipes financières connaissent déjà cette distinction entre calcul et jugement. Ce guide sur l’utilisation de l’analyse de données pour éclairer les décisions financières complète utilement cette approche : la décision reste entre les mains de la personne responsable des chiffres.
Étapes de l’analyse : qui fait quoi ?
| Étape | Ce que l’IA peut préparer | Ce qu’une personne doit confirmer |
|---|---|---|
| Nettoyage des données | Corrections de types, dédoublonnage et code de filtrage | Les règles de nettoyage correspondent au système source |
| Rédaction du code | Scripts de jointure, d’agrégation et de test | Le code s’exécute sur un instantané des données et répond à la question posée |
| Graphiques et synthèses | Code des graphiques et synthèses en langage courant | Les axes, les totaux et les libellés correspondent aux données sous-jacentes |
| Tests statistiques | Choix du test et code associé | Les hypothèses sont respectées et le test utilisé est adapté |
Chaque ligne doit produire un élément qu’une personne chargée de la vérification peut ouvrir : un script de nettoyage, un fichier de résultats daté ou une courte liste d’hypothèses accompagnant un test. Un simple paragraphe dans une conversation ne permet aucun audit.
Règle de travail : si une deuxième personne ne peut pas reproduire l’étape à partir d’un fichier enregistré, cette étape n’est pas terminée.
Avant d’ouvrir un outil, répartissez deux ou trois de vos tâches récurrentes dans ce tableau. Placez « rédiger la jointure » du côté du modèle et « confirmer la granularité des données » du vôtre.
Confidentialité : les vérifications avant tout import
Un tableur de factures, de contrats ou de notes clients n’est pas un fichier anodin. Avant qu’il ne quitte votre organisation, consignez cinq vérifications et conservez les réponses dans le dossier du projet, à côté des scripts et des instantanés qui seront examinés plus tard.
Utilisation pour l’entraînement. Vérifiez que les conversations et les fichiers sont exclus de l’entraînement des modèles. Nous n’utilisons pas les conversations ni les fichiers de nos utilisateurs pour entraîner l’IA.
Conservation et sous-traitants. Notez la durée de conservation des contenus et les prestataires qui y ont accès. Nous avons conclu des accords de conservation nulle des données avec tous les fournisseurs de modèles d’IA avec lesquels nous travaillons.
Lieu d’hébergement. Identifiez la région où les données sont hébergées. Les données de nos utilisateurs sont hébergées dans l’Union européenne et la plateforme est conforme au RGPD.
Modalités de suppression. Précisez ce que vous pouvez supprimer vous-même dans le produit et ce qui nécessite une demande écrite au fournisseur. Lisez les conditions de suppression publiées par le service avant tout import : ce sont elles, et non le bouton lui-même, qui définissent ce qu’une suppression efface réellement.
Exceptions pouvant retarder l’effacement. Une obligation légale ou un litige en cours peut justifier la conservation d’une copie, même après votre demande de suppression.
La Commission européenne explique qu’une personne peut demander l’effacement de ses données lorsqu’elles ne sont plus nécessaires ou qu’elles ont été traitées de manière illicite. Ce droit n’est pas absolu. Des exceptions peuvent s’appliquer au titre de la liberté d’expression et d’information, du respect d’une obligation légale, ou de la constatation, de l’exercice ou de la défense de droits en justice. L’article 17 du règlement général sur la protection des données impose au responsable du traitement d’effacer les données personnelles dans les meilleurs délais lorsqu’un motif applicable le justifie, notamment si elles ne sont plus nécessaires à la finalité prévue, si le consentement a été retiré sans autre base juridique ou si le traitement ne respecte pas le règlement.
Ce qu’un bouton de suppression ne garantit pas
La suppression ressemble à la fin de mission d’un prestataire : révoquer ses accès est une chose, savoir ce qu’il advient des copies déjà réalisées en est une autre. Un bouton dans une fenêtre de conversation couvre le premier volet. Il ne vous montre pas comment le second est traité. C’est pourquoi les conditions écrites comptent davantage que l’interface. Un service digne de confiance explique clairement ce que couvre une suppression et ce qu’une demande formelle permet d’obtenir. Lisez ces conditions pour chaque service que vous utilisez, y compris le nôtre, avant d’importer un véritable fichier client.
Notre guide de l’espace de travail IA explique comment les fichiers sont organisés dans un espace partagé. C’est le bon moment pour confronter les vérifications écrites ci-dessus au produit que vous utilisez.
Avant l’import, supprimez ou pseudonymisez les noms, coordonnées bancaires et autres identifiants personnels. Conservez l’instantané daté créé lors de la préparation dans un espace de stockage contrôlé par votre équipe. Le modèle doit voir les colonnes nécessaires à la question, pas un export complet de données personnelles.
Un fichier que vous n’enverriez pas par e-mail à un prestataire inconnu n’a pas non plus sa place dans un prompt.
Préparer vos données avant de rédiger un prompt
C’est la préparation qui rend un résultat reproductible. Si vous la négligez, le modèle répondra quand même. Vous ne pourrez simplement pas montrer d’où vient sa réponse.
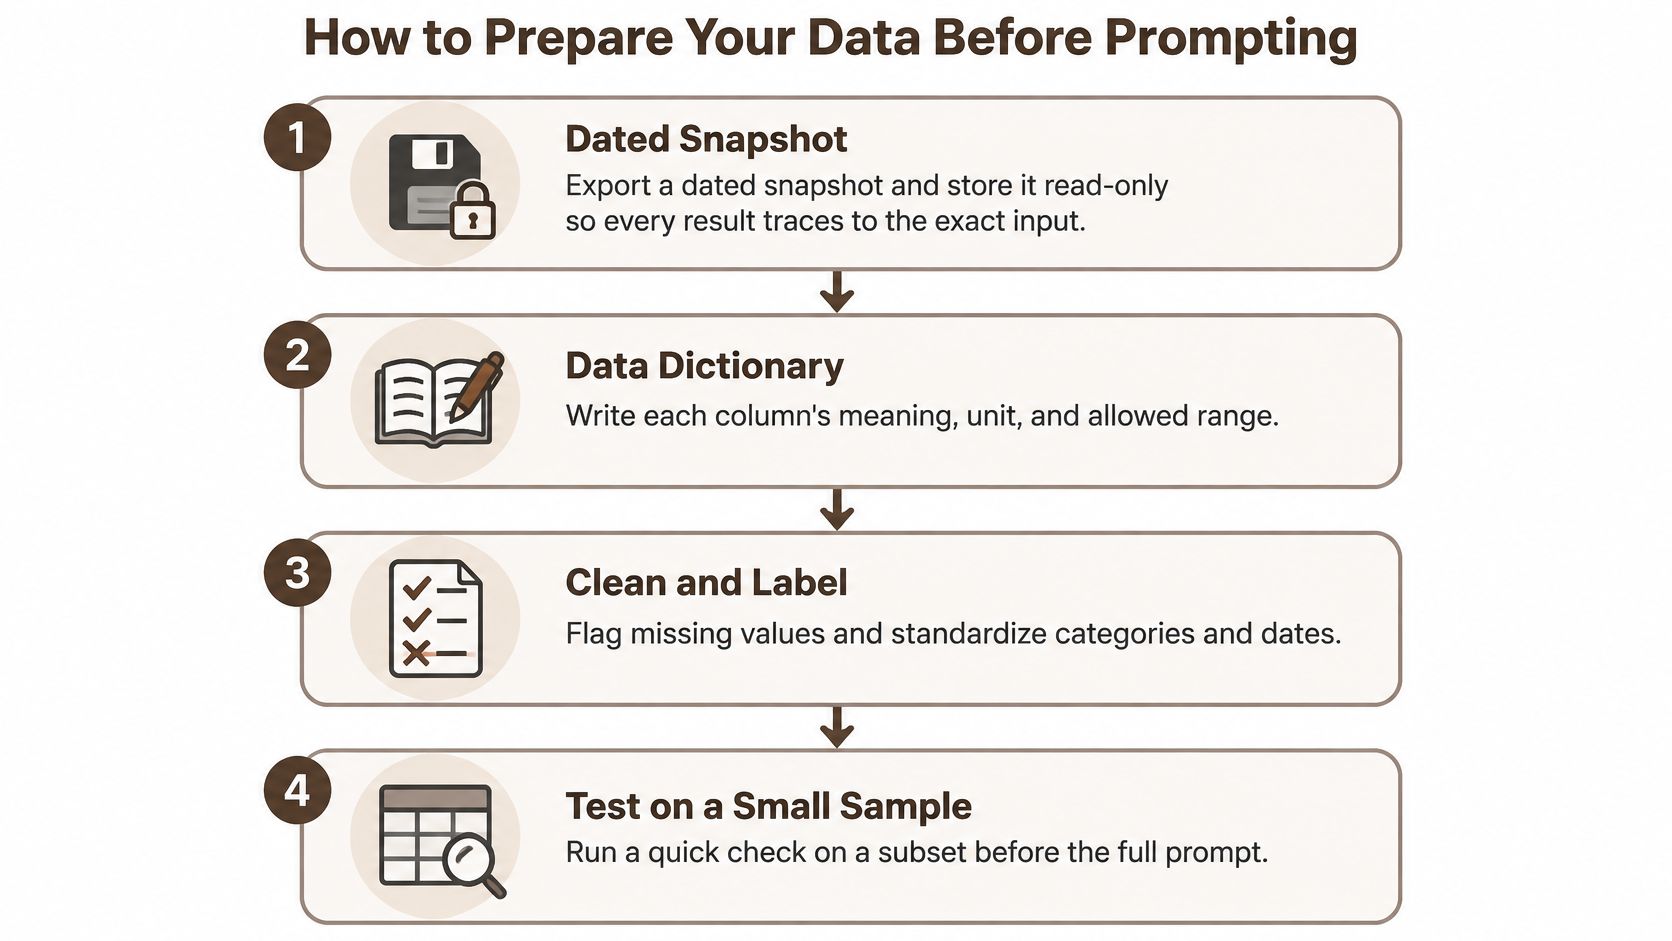
- Exportez un instantané daté et conservez-le en lecture seule. Copiez le fichier source, ajoutez la date à son nom et ne modifiez plus cette copie. Sans elle, vous ne pourrez pas reproduire les chiffres du mois dernier après l’actualisation de l’export courant.
- Rédigez un dictionnaire de données. Pour chaque colonne, indiquez sa signification, son unité, son type et les valeurs autorisées. Une colonne de chiffre d’affaires peut être exprimée en milliers dans un fichier et en euros dans un autre. L’absence de dictionnaire est une cause fréquente d’erreurs d’unité.
- Contrôlez le schéma des données. Repérez les clés en double, les formats de date hétérogènes et les nombres stockés sous forme de texte. Imaginons qu’un identifiant client apparaisse deux fois avec des régions différentes. Définissez par écrit la règle à appliquer avant tout prompt, sinon la jointure doublera les ventes.
- Comptez les valeurs manquantes par colonne. Notez si les champs vides semblent aléatoires ou structurels. Un champ de remise vide signifie souvent qu’aucune remise n’a été appliquée, et non que la valeur est inconnue. Considérer toutes les cases vides comme des données « manquantes de façon aléatoire » risque de biaiser un taux.
- Formulez la question en une phrase. Précisez la population, la période et le résultat étudié. « Le taux d’attrition des abonnés payants au premier trimestre, défini par l’absence de facture dans les 30 jours suivants » constitue une question exploitable. « Que se passe-t-il avec les clients ? » n’en est pas une.
- Réservez un échantillon annoté de 50 à 200 lignes dont vous connaissez les réponses. Il vous servira à tester les résultats. Si vous n’exécutez le code que sur le fichier complet, une erreur de dénominateur peut se cacher dans un total important.
Si la source est un relevé PDF ou une photo de facture papier, convertissez-la en texte avant de vous fier à une colonne. Ce comparatif des méthodes d’extraction à partir de PDF et de photos aide à mesurer les erreurs que la conversion elle-même peut introduire. Une fois le fichier converti en véritable tableau, les mêmes règles d’instantané et de dictionnaire s’appliquent. Notre article sur l’analyse de données dans un tableur explique comment interroger un classeur importé en s’appuyant sur ses propres feuilles.
Une préparation rigoureuse paraît ennuyeuse, et c’est justement le but. Vous obtenez un instantané, un dictionnaire, un décompte des anomalies et une question écrite. Le prompt vient après ces quatre éléments, pas avant.
Demander à l’IA du code plutôt que des conclusions
Demandez un script exécutable, un plan d’analyse et une liste d’hypothèses. Ne demandez pas au modèle de regarder un tableau pour en décréter la tendance. Une réponse rédigée ne laisse rien à auditer lorsque sa formulation change ou que le modèle est mis à jour.
Un prompt fonctionne mieux en quatre blocs.
La question précise la population, le traitement ou la variable d’entrée, le résultat étudié et la période. Le dictionnaire est joint ou collé, unités comprises. Les livrables sont un plan d’analyse, du code exécutable et les hypothèses sur lesquelles repose ce code. Les contraintes fixent la graine aléatoire, précisent les versions des logiciels et exigent le nom du test à chaque mention d’une valeur p.
Un prompt vague et un prompt solide
Supposons que vous étudiiez l’attrition des clients d’une enseigne. Un prompt vague demande : « Quels clients vont partir ? » Le modèle peut répondre par un paragraphe assuré et un classement inventé. Vous ne pouvez ni reproduire le résultat ni voir le dénominateur.
Un prompt solide demande : « Écrivez un script Python portant sur les clients payants de l’enseigne en 2024. Calculez le taux d’attrition mensuel par cohorte d’inscription. Produisez un tableau de résultats. Indiquez le dénominateur utilisé pour chaque taux. Fixez la graine aléatoire. Précisez les versions des bibliothèques. Listez toutes les hypothèses, y compris la règle de datation de la résiliation d’un compte. »
L’oubli le plus courant concerne l’unité d’analyse. Précisez-la dans la question elle-même : « une ligne par client et par mois » ou « une ligne par commande ». Si la granularité reste vague, le modèle agrégera les données au niveau qui lui permet de produire un graphique bien lisse.
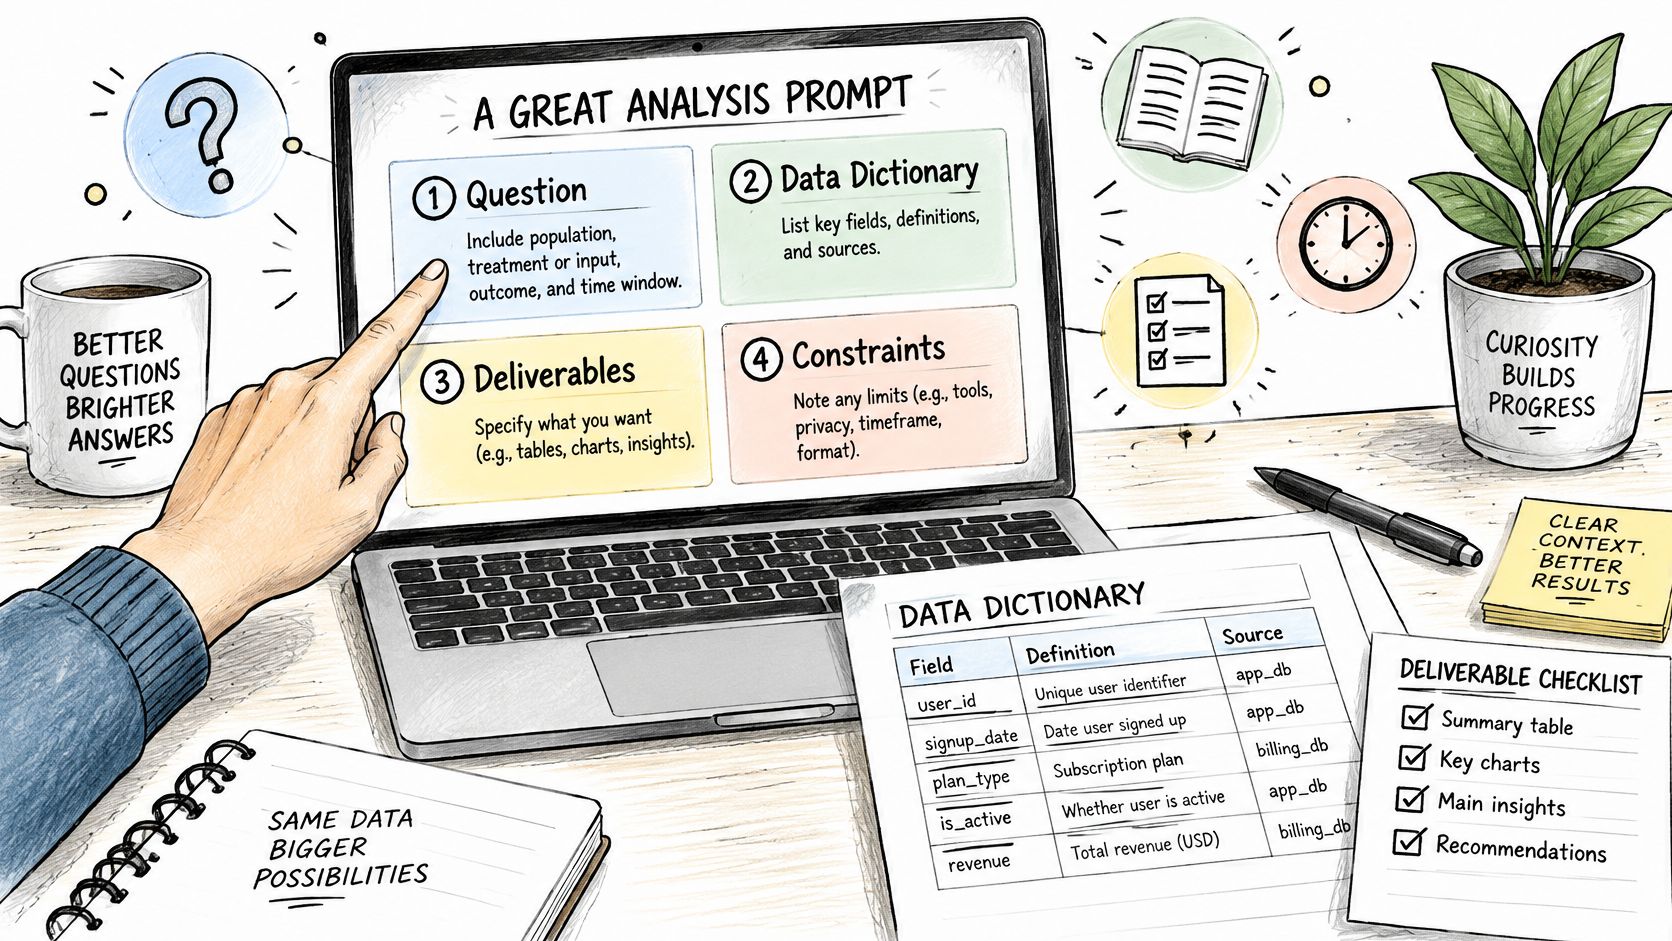
Réutilisez cette liste de contrôle pour votre prochaine analyse.
- Bloc question : la population, la variable d’entrée, le résultat étudié et la période sont précisés.
- Granularité : le niveau de chaque ligne est explicite, par exemple une ligne par client et par mois.
- Dictionnaire : les unités, les types et les valeurs autorisées figurent dans le prompt, sans rester implicites.
- Éléments à conserver : vous avez demandé un plan, du code exécutable et une liste d’hypothèses.
- Contraintes : la graine aléatoire, les versions des logiciels et le nom du test associé à chaque valeur p sont exigés.
Enregistrez le texte du prompt à côté du script. Un résultat que vous ne pouvez pas rattacher à ces cinq points relève du récit, pas de l’analyse.
Vérifier les résultats de l’IA avant de s’y fier
Une personne chargée de la vérification effectue les six mêmes contrôles sur chaque résultat avant que quiconque ne le cite.
Contrôles des résultats et signaux d’alerte
| Contrôle | Éléments à comparer | Signal d’alerte |
|---|---|---|
| Nombre de lignes | Lignes sources et lignes après jointures et filtres | Ajout ou perte de lignes inexpliqué |
| Totaux | Totaux produits et somme calculée indépendamment à partir de la source | Écart supérieur à une erreur d’arrondi |
| Dénominateurs | Pourcentages et population qu’ils décrivent | Taux calculés sur une mauvaise base |
| Unités | Devises, échelles et unités de temps par rapport au dictionnaire de données | Valeurs ou en-têtes incompatibles avec le dictionnaire |
| Nouvelle exécution | Deux exécutions avec le même code et la même graine aléatoire | Chiffres différents d’une exécution à l’autre |
| Référence | Résultat de l’IA et tableur fiable ou rapport antérieur | Écart que personne ne peut expliquer |
Pourquoi un score unique ne suffit pas
Un bon score sur un questionnaire fixe ne garantit pas que le même script tiendra la route sur le fichier du mois prochain. Le NIST rappelle que l’exactitude mesurée sur un jeu de référence porte sur un ensemble fixe d’éléments, tandis que l’exactitude généralisée concerne la population plus large d’éléments similaires. Ventilez vos propres résultats par type de données, présence de valeurs manquantes et sous-groupe. Présentez un intervalle de confiance ou un intervalle obtenu par bootstrap, pas un chiffre isolé.
Distinguez les résultats corrects dès la première tentative de ceux obtenus après avoir renvoyé une erreur au modèle. Un chiffre qui n’apparaît qu’après plusieurs corrections mérite un examen plus attentif. Le modèle s’adapte peut-être à vos indices plutôt qu’aux données.
Surveillez particulièrement trois erreurs mécaniques. Une fuite de données entre l’échantillon d’entraînement et l’échantillon de test donne une exactitude artificiellement élevée. Une jointure qui duplique les clés gonfle les totaux. Un taux calculé avec le mauvais dénominateur, par exemple l’ensemble des visiteurs au lieu des comptes payants, peut inverser une conclusion. Les équipes e-commerce rencontrent les mêmes pièges dans les rapports de leurs plateformes. Ce guide de vérification des chiffres des rapports BigCommerce montre pourquoi un total enregistré et un total recalculé peuvent différer pour des raisons ordinaires. C’est ce même réflexe de vérification qu’il faut appliquer aux résultats de l’IA.
Exécutez le code généré dans un environnement contrôlé, avec des versions de bibliothèques figées. Ne le connectez pas directement à une base de données de production. Relancez ensuite l’analyse avec une autre spécification et ajoutez, si possible, un contrôle négatif, par exemple une période durant laquelle le traitement ne pouvait pas avoir eu d’effet. Si le résultat s’inverse lorsque vous modifiez un choix arbitraire, signalez-le avant de le communiquer.
Aucun chiffre produit par l’IA ne sort de l’équipe tant qu’il ne concorde pas avec une référence indépendante, ou que l’écart n’est pas expliqué par écrit.
Si vous transformez ensuite les tableaux vérifiés en un compte rendu rédigé, conservez le script en pièce jointe. Notre article sur la manière de générer un rapport porte sur cette transmission : il ne remplace pas les six contrôles.
Quand l’IA doit passer le relais aux experts
Un modèle affirmera sans hésiter qu’une campagne de printemps a entraîné une hausse de 12 %. Un responsable marketing qui connaît le calendrier verra ce qui cloche : Pâques a changé de date, une remise n’a été proposée que dans une région et les magasins « témoins » étaient déjà en croissance. La comparaison ne démontre pas de causalité. Pourtant, la phrase donne cette impression.
C’est ce type de défaillance qu’il faut anticiper. Le travail descriptif peut rester confié au modèle, sous contrôle humain : nettoyage, synthèse, graphiques et rédaction de code. Les affirmations à risque élevé n’entrent pas dans cette catégorie.
Toute affirmation à risque élevé exige un responsable désigné :
- Affirmations causales. « Cette campagne a provoqué le changement » exige un protocole d’étude, pas un graphique.
- Équité entre sous-groupes. Un écart selon la région, l’âge ou le type de contrat ne constitue pas un constat valide tant que le regroupement n’est pas justifié.
- Décisions cliniques ou financières. Un seuil qui modifie un traitement médical, un crédit ou une rémunération relève de la décision, pas de la synthèse.
- Extrapolation. Une prévision au-delà de la période observée reste un scénario tant que personne n’en assume les hypothèses.
Avant toute action, un expert métier vérifie les hypothèses sur le processus de génération des données, les facteurs de confusion, l’intervalle d’incertitude, le mécanisme à l’origine des valeurs manquantes et au moins une autre explication possible. La saisonnalité, le mode de sélection des personnes ou entités recevant le traitement et un changement de définition du résultat étudié sont des explications alternatives fréquentes. Si aucune n’a été consignée, l’affirmation n’est pas prête à être utilisée.
Le modèle n’est pas le décideur responsable. Si une conclusion établie avec l’aide de l’IA cause un préjudice, l’organisation reste responsable de la validation, de la documentation et de la remontée des problèmes. Tenez un bref registre : qui a examiné l’affirmation, à quelle date et quels éléments cette personne a refusé de valider. Ce registre constitue la pièce justificative, au même titre qu’un script pour une jointure.
La rapidité n’est pas le critère ici. Une conclusion plus lente à établir mais vérifiable vaut mieux qu’une affirmation assurée que personne ne peut défendre.
Tester la méthode sur un rapport récurrent
Choisissez un rapport dont vous jugez déjà les résultats fiables, par exemple le bilan des ventes du trimestre précédent ou un rapprochement mensuel des factures. Ne commencez pas par votre fichier le plus désordonné.
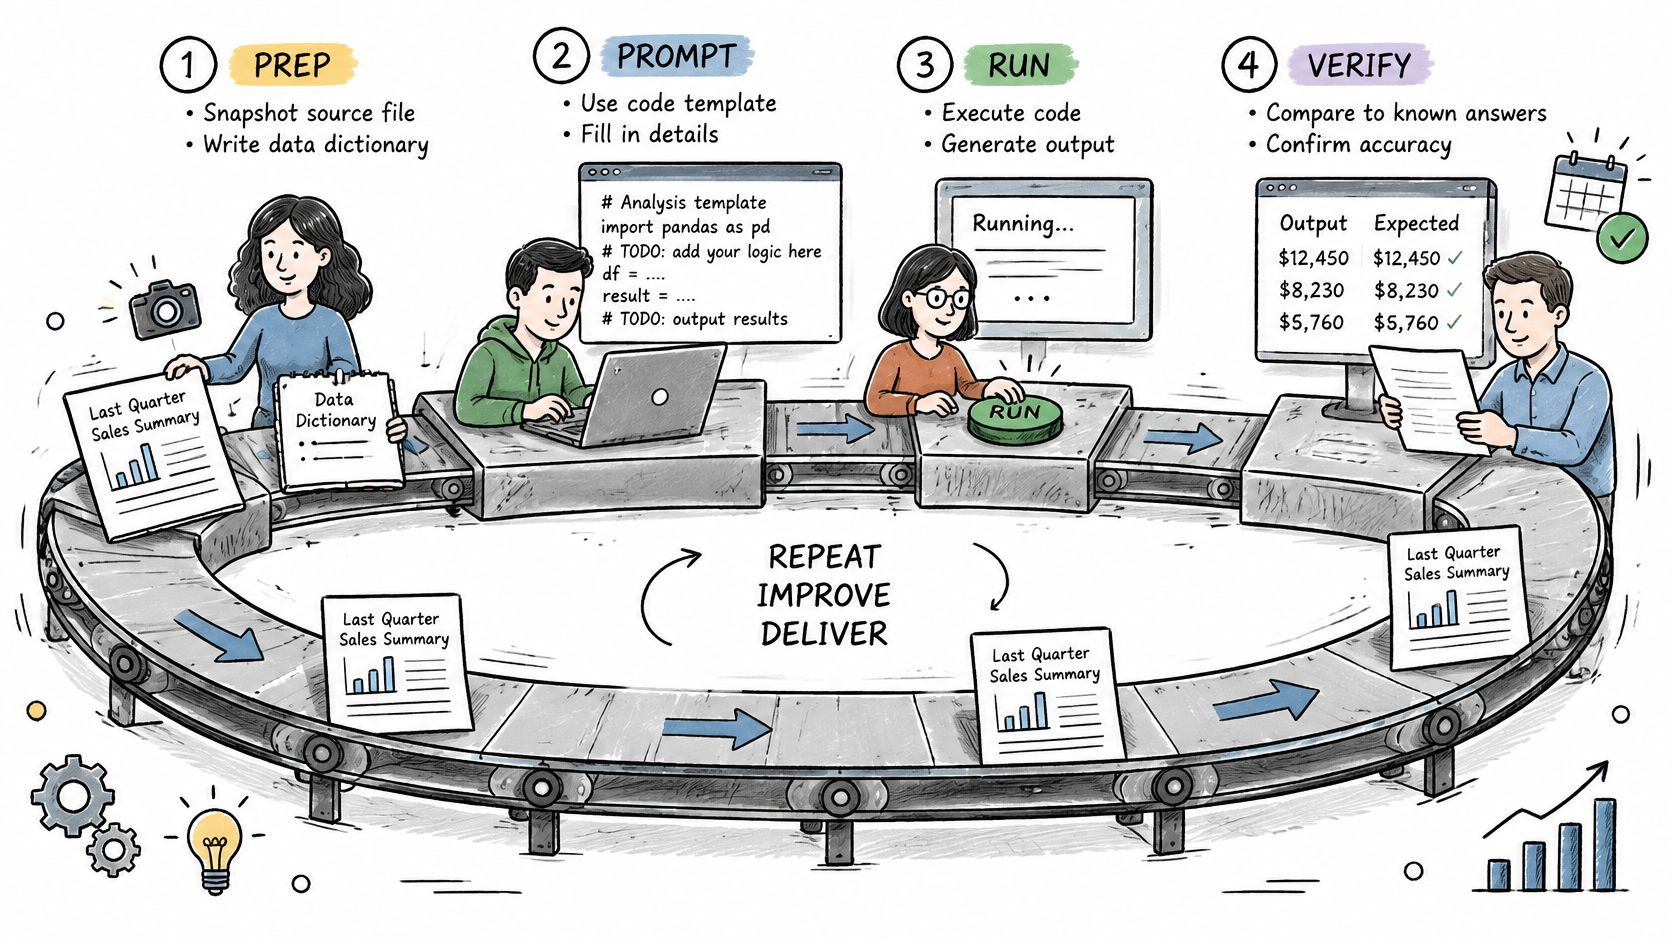
- Préparez. Créez d’abord l’instantané daté et le dictionnaire de données.
- Demandez du code. Utilisez le modèle de prompt en quatre blocs, plutôt qu’une demande de verdict.
- Vérifiez. Effectuez les six contrôles des résultats en les comparant à la référence connue.
- Consignez l’exécution. Enregistrez le prompt, le nom et la version du modèle, les paramètres d’échantillonnage et la graine aléatoire.
- Documentez chaque écart entre les nouveaux chiffres et le rapport précédent.
Ne validez le pilote que si ses résultats correspondent à la référence, aux arrondis près, et si chaque affirmation à risque élevé a une personne désignée pour la vérifier. Ne passez à un deuxième rapport qu’après cette validation. Dans le cas contraire, corrigez l’étape la plus fragile avant d’élargir le périmètre.
Pour comparer des modèles, soumettez le même échantillon annoté à chacun et consignez quel modèle a produit chaque résultat. Nous réunissons ChatGPT, Claude, Gemini, Mistral et d’autres modèles sur une même plateforme européenne. Une exécution en mode agent peut joindre les sources issues d’une recherche web en direct pour vous permettre de les vérifier. Les données d’entrée restent identiques. Seul le modèle change.
BromeAI est un espace de travail européen qui vous permet d’interroger des tableurs, des PDF et des notes avec plusieurs modèles, sans que vos conversations ni vos fichiers servent à leur entraînement. Utilisez-le pour rédiger le code, conserver les sources associées et laisser la validation à la personne que vous avez désignée. Rendez-vous sur BromeAI pour appliquer cette démarche traçable à votre prochain rapport récurrent.